flowchart LR
    WT["`🏗 **webtrees Core**<br/>2.2 / 2.3`"]

    subgraph modules_v4["📦 modules_v4"]
        LE["🔗 LinkEnhancer"]
        CJ["⏰ Cronjob"]
        WS["📚 wt-shared-libs"]
    end

    WT -->|Module-API| LE
    WT -->|Module-API| CJ
    LE -->|PSR-4 Autoload| WS
    CJ -->|PSR-4 Autoload| WS

    LE -->|"cron-jobs.php<br/>(Manifest)"| CJ
    CJ -->|führt aus| CLI["🛠 LE-CLI-Skripte<br/>build-link-index<br/>build-uid-index<br/>refresh-wthb-toc"]

    classDef coreStyle fill:#e3f2fd,stroke:#1565C0,stroke-width:2px
    classDef leStyle fill:#e8f5e9,stroke:#2E7D32,stroke-width:2px
    classDef cjStyle fill:#fff3e0,stroke:#E65100,stroke-width:2px
    classDef wsStyle fill:#f3e5f5,stroke:#7B1FA2,stroke-width:2px
    classDef cliStyle fill:#f5f5f5,stroke:#616161,stroke-width:1px

    class WT coreStyle
    class LE leStyle
    class CJ cjStyle
    class WS wsStyle
    class CLI cliStyle
1 - Cronjob
Cron-Job-Scheduler-Dienst für webtrees
Ein Cron-Job-Scheduler-Dienst für webtrees: plane Wartungs-/Batch-Jobs mit Standard-Cron-Ausdrücken, beobachte deren Ausführungshistorie in der Admin-UI und trigger sie manuell. Das Modul ist der Dienst; das OS (klassisches Cron oder ein systemd-Timer) muss nur ein kleines Skript einmal pro Minute aufrufen.
Job-Registry + Ausführungshistorie in zwei eigenen Tabellen (cj_job, cj_run)
Isolierte Ausführung: jeder Job läuft als separater PHP-Kindprozess (proc_open, kein Shell), mit pro-Job-Timeout und erfasster Ausgabe
Selbst-Registrierung: andere Module können ihre Jobs anbieten (ein cron-jobs.php
-Manifest oder eine getCronJobs()-Methode); sie erscheinen hier, deaktiviert erstellt und bereit zum Aktivieren
Ereignisgesteuerte Jobs: Jobs können auf Ereignisse statt auf Zeitpläne reagieren — über einen token-geschützten Webhook, einen direkten EventQueue::push()-Aufruf, die eingebauten Pseudo-Event-Poller oder Route-Events
Fehlerbenachrichtigung: pro-Job-Opt-in zur Benachrichtigung der Admin-Konten bei Job-Fehlern
Offline-Bewusstsein: während data/offline.txt existiert, wird der Tick vor jedem Datenbankzugriff übersprungen
Keine Core-Änderungen, keine Änderungen an anderen Modulen
Ursprünglich entwickelt als Support-Modul für LinkEnhancer, um dessen Indizes aktuell zu halten.
Support
Issues: Für Ideen oder beim Finden eines Bugs kann ein Issue erstellt werden.
Ein Trigger: klassisches Cron, ein systemd-Timer, eine Windows Task Scheduler-Aufgabe, oder der eingebaute Watch-Daemon (kein OS-Timer nötig — siehe “Trigger-Installation”)
1.1.2 - Installation
Schritt-für-Schritt-Installation und Trigger-Setup
Modulordner nach modules_v4/cronjob/ kopieren (ZIP-Installation geht auch). Die Cron-Bibliothek ist im Modul enthalten — nichts zu holen.
Webtrees einmal öffnen (irgendeine Seite als Admin), damit das Modul-boot() seine Tabellen erstellt.
Trigger installieren (klassisches Cron, systemd-Timer oder Windows Task Scheduler — die Admin-Seite des Moduls generiert den Block für Ihr OS mit den Pfaden dieser Installation bereits ausgefüllt).
Trigger-Installation (einmalig) — siehe unten.
Erstellen Sie Ihren ersten Job in der Admin-UI oder konfigurieren und aktivieren Sie registrierte Jobs.
Trigger-Installation (einmalig)
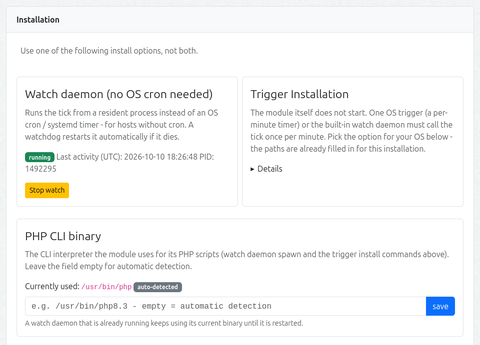
Wichtig — PHP-CLI-Binary: Die Installation-Akkordeon auf der Admin-Seite zeigt, welcher PHP-CLI-Interpreter derzeit aufgelöst wird (Badge: auto-erkannt / manueller Pfad) und erlaubt das Festpinnen eines manuellen Pfads.
Es ist wichtig zu prüfen, ob Ihr Webserver eine PHP-CLI-Binary (SAPI) bereitstellt und ob das Modul korrekt konfiguriert ist, um sie zu verwenden. Andernfalls wird Tick nicht funktionieren.
Der Tick ist so konzipiert, dass er alle 60 Sekunden läuft. Er erfasst Cron-Jobs, Commands und Events, triggert Events und verarbeitet die Task-Queue.
Wählen Sie eine der auf der Admin-Seite gezeigten Optionen:
Option A — klassisches Cron
Eine Zeile in der Crontab des Webserver-Nutzers, läuft jede Minute:
# /etc/systemd/system/cronjob-tick.timer[Unit]Description=Run the webtrees cronjob tick every minute[Timer]OnBootSec=1minOnCalendar=*:*:00Persistent=true[Install]WantedBy=timers.target
Klicken Sie Start watch auf der Admin-Seite. Ein Resident-Prozess führt den Tick alle 60 Sekunden aus, und ein Page-Load-Watchdog startet ihn neu, falls er stirbt. Verwenden Sie es, wenn der Host kein Cron und keinen systemd-Zugriff hat, oder für Tests — auf Windows-Hosts ist dies die einfachste Option.
stateDiagram-v2
    [*] --> Stopped: (initial)
    Stopped --> Running: Watch starten (Admin-UI)
    Running --> TickLoop: tick alle 60 s
    TickLoop --> TickLoop: Job ausführen
    TickLoop --> Dead: ⚠ Prozess stirbt
    Dead --> Running: 🔄 Watchdog respawn<br/>(nächster Page-Load<br/>Cooldown 5 min)
    Running --> Stopped: Watch stoppen
    Dead --> Stopped: Watch stoppen<br/>(kein Respawn)

    note right of Running
        🔒 Hält data/cronjob/watch.lock
        🆔 PID sichtbar in Admin-UI
        🛡 Überlebt FPM-Worker-Recycle (setsid)
    end note
Option D — Windows Task Scheduler
Die Admin-Seite generiert das XML mit bereits ausgefüllten Pfaden. Speichern Sie es als wt-cronjob-tick.xml (UTF-8) und führen Sie schtasks /Create /F /XML wt-cronjob-tick.xml einmal in einer erhöhten Eingabeaufforderung aus.
1.1.3 - Admin-Einstellungen
Webtrees Modul-Einstellungen
Verfügbare Optionen auf der Admin-Seite:
Ereignis-Katalog
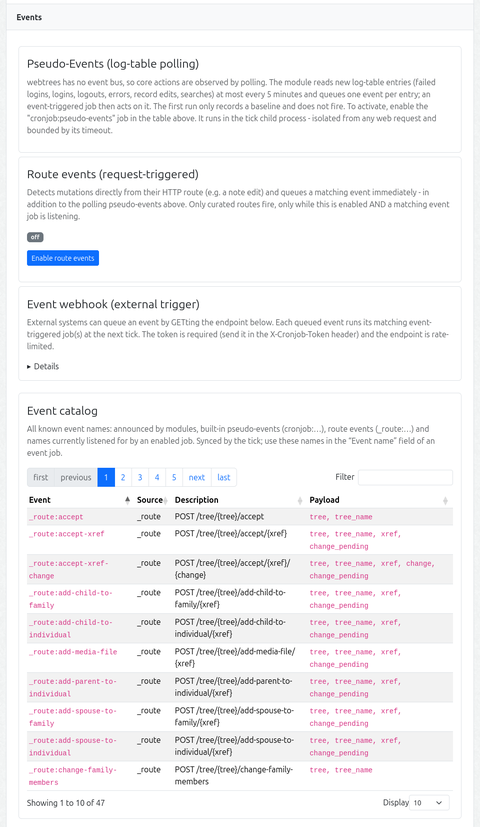
Die Admin-Seite (Events-Abschnitt) und die Ereignisnamen-Vorschläge im Job-Formular werden von einer Ereignis-Inventur (cj_event_catalog, vom Tick synchronisiert wie die Job-Registry) gespeist. Sie mischt in dieser Prioritätsreihenfolge:
Events, von Modulen angekündigt (Manifest-events-Abschnitt / getModuleEvents()), namespaced <module>:<name>
Route-Events (_route:*, abgeleitet aus der live Routentabelle)
Ereignisnamen, die derzeit abgehört werden von einem aktiven Event-Job (Quelle listening) — dies deckt Webhook-only-Namen ab
Jeder Eintrag trägt seine Quelle, eine Beschreibung (als Übersetzungsschlüssel gespeichert, nur zur Render-Zeit übersetzt) und die bekannten Payload-Parameter-Namen. Für Route-Events wird der Payload aus dem Routenpfad abgeleitet: die {param}-Platzhalter in der Reihenfolge ihres Auftretens, wobei {tree} sich zu tree + tree_name ausdehnt (spiegelnd, was der live Event-Payload trägt). Für Pseudo-Events kommen beide vom Detektor (description() / payloadKeys()). Die vollständige Liste ist auch das, was das “Ereignisname”-Datalist im Job-Formular bietet. Der Katalog wird als Client-seitige DataTables (Sortieren/Filtern/Paginieren) im Events-Abschnitt gerendert.
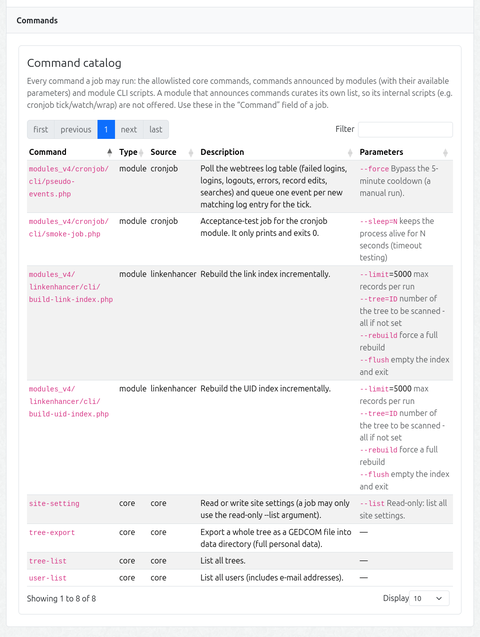
Befehls-Katalog
Die Befehls-Vorschläge im Job-Formular und die Admin-Seite (Events-Abschnitt) werden von einer Befehl-Inventur (cj_command_catalog, vom Tick synchronisiert wie die anderen) gespeist. Sie mischt in dieser Prioritätsreihenfolge (erste Quelle gewinnt pro Befehl):
die allowlisteten Core-Befehle (tree-export, tree-list, user-list, site-setting), mit ihren bekannten Parametern
Befehle, von Modulen angekündigt (Manifest-commands-Abschnitt / getModuleCommands()) — mit einer Beschreibung und strukturierten Parametern
Modul-CLI-Skripte, gefunden per Glob (modules_v4/<module>/cli/*.php), außer für ein Modul, das Befehle angekündigt hat (das Modul kuriert seine eigene Liste, daher werden seine internen Skripte nicht angeboten)
Jeder Eintrag trägt seinen Typ (module / core), seine Quelle, eine Beschreibung (Übersetzungsschlüssel, zur Render-Zeit übersetzt) und die verfügbaren Parameter (strukturiert: Name, optional, Default, Beschreibung). Im Job-Formular zeigt die Eingabe eines Befehls, der mit einem angekündigten Befehl übereinstimmt, seine Parameter als Hinweis unter dem Feld.
Fehlerbenachrichtigung
Ein Job kann als Bei Fehler benachrichtigen markiert werden. Wenn ein solcher Job fehlschlägt (nicht-null Exit oder Timeout), werden die Administrator-Konten der Site über webtrees’ eigenes MessageService::deliverMessage() alarmiert — das über das interne Nachrichtensystem und/oder E-Mail entsprechend der eigenen Kontaktmethode-Präferenz jedes Empfängers liefert. Es werden keine Adressen im Modul gespeichert und kein Kanal ist hartkodiert: die Empfänger sind die Admin-Benutzerkonten, und wie sie erreicht werden, folgt den Nachrichten-Einstellungen der Site.
Die Benachrichtigung trägt den Job-Namen, Status, Exit-Code, Dauer und einen kurzen Schwanz der erfassten Ausgabe. Sie läuft im Tick (keine Web-Anfrage), daher trägt sie keinen Link über den Text hinaus. Ein Benachrichtigungsproblem bricht nie den Tick.
1.2 - Verwendung
Jobs erstellen, Ausführungshistorie und Admin-UI
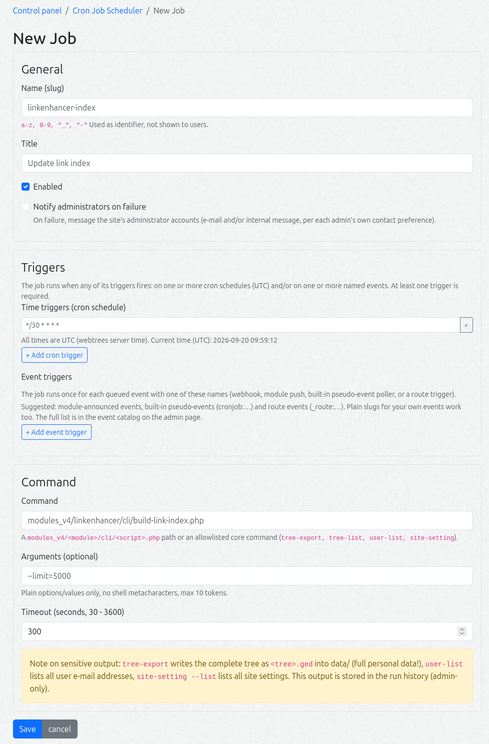
Job erstellen
Steuerungspanel → Cron Job Scheduler → Neuer Job:
Feld
Bedeutung
Name (Slug)
technischer Bezeichner, a-z 0-9 _ -. Nur-lesen für durch Module angebotene Jobs (deren <module>:<name>-Schlüssel ist fix); editierbar für selbst erstellte Jobs.
Titel
menschenlesbarer Name
Trigger
ein oder mehrere Zeit-Trigger (Cron-Zeitpläne) und/oder Ereignis-Trigger — der Job feuert, wenn irgendein Trigger feuert. Mindestens einer ist erforderlich.
Cron-Ausdruck
(Zeit-Trigger) Standard-5-Feld-Cron oder ein Makro (@daily, @weekly, …). Zeiten sind UTC.
Ereignisname
(Ereignis-Trigger) das Ereignis, auf das dieser Job reagiert. Slug oder <domain>:slug, max. 64 Zeichen.
Befehl
ein modules_v4/<module>/cli/<script>.php-Pfad oder ein erlaubter Core-Befehl.
Argumente
nur einfache Optionen/Werte (z.B. --limit=5000), max. 10 Tokens
Timeout
30 - 3600 s
Bei Fehler benachrichtigen
Opt-in: Admin-Konten bei Job-Fehlern benachrichtigen
Verfügbare Ereignisnamen und Befehle werden als Datalists bereitgestellt, um die Dateneingabe zu erleichtern.
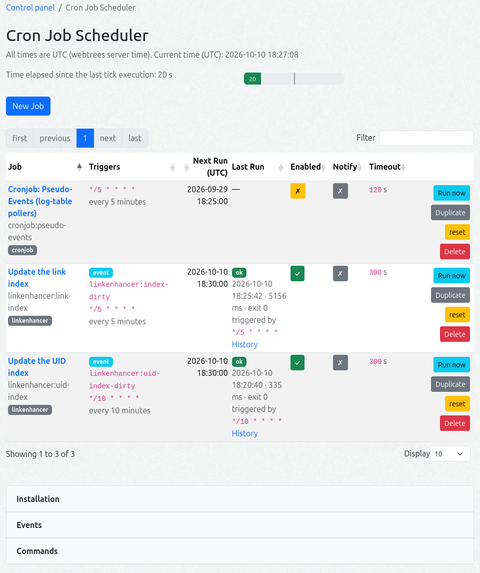
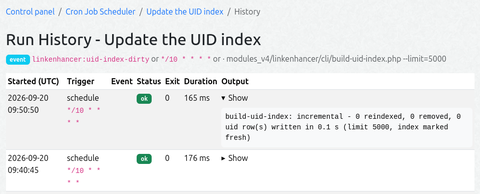
Der Jetzt ausführen-Button stellt den Job für den nächsten Tick in die Warteschlange (≤ 60 s). Die Verlauf-Seite zeigt Status, Exit-Code, Dauer, den auslösenden Trigger und die erfasste Ausgabe (letzte 64 KB) der letzten 25 Läufe pro Job (plus 30-Tage-globale Aufbewahrung).
Die Job-Tabelle ist ein Client-seitiger DataTable (Suchfeld, sortierbare Spalten, Paginierung, Status im Browser gespeichert). Die Spalten Aktiviert und Benachrichtigung können an Ort und Stelle umgeschaltet werden. Pro Zeile: Duplizieren und Zurücksetzen (stellt modulangebotene Standardwerte wieder her).
1.3 - Der Tick
Wie ’tickt’ das Modul
Der Tick ist das Herz des Moduls: einmal pro Minute prüft er alle aktivierten Jobs, entscheidet, was fällig ist, und führt es aus. Weder das webtrees-Core noch das Betriebssystem planen selbst — sie starten nur tick.php
.
flowchart TD
    subgraph Triggers["`⏱ Auslöser *(once per minute)*`"]
        CRON["`🕑 OS cron / systemd<br/>*every minute*`"]
        WATCH["`👁 watch-Daemon<br/>*(in-module)*`"]
    end

    subgraph Guard["🛡 Guard"]
        TP["`📄 cli/tick.php · **cron:tick**<br/>*guard(): 403 over HTTP*`"]
        OFF{"`⚠ site offline?<br/>*data/offline.txt*`"}
        BOOT["`🚀 boot()<br/>*webtrees + DB*`"]
    end

    subgraph Selection["🔎 Arbeit auswählen"]
        TIME["`📅 time-based jobs<br/>**next_run_at due** *(UTC)*`"]
        CE[("`📦 cj_event<br/>*Event-Warteschlange*`")]
        DRAIN["`🧮 drain queue<br/>*coalesced · 60 s budget*`"]
    end

    subgraph Execution["`⚙ Ausführung *(isolated child)*`"]
        RUN["`🧪 JobRunner<br/>**proc_open**`"]
        LIM["`⏲ timeout 30–3600 s<br/>last **64 KB** · exit code`"]
    end

    subgraph Storage["💾 Speicherung"]
        CJRUN[("`cj_run<br/>*Laufverlauf*`")]
        MARK["`🏷 tick.last<br/>*stale > 300 s → tick_stale*`"]
    end

    CRON --> Guard
    WATCH --> Guard
    TP --> OFF
    OFF -->|"offline"| SKIP["⏭ Tick überspringen"]
    OFF -->|"online"| BOOT
    BOOT --> TIME
    BOOT --> DRAIN
    CE --> DRAIN
    TIME --> Execution
    DRAIN --> Execution
    RUN --> LIM
    LIM --> CJRUN
    BOOT --> MARK

    classDef sourceStyle fill:#e3f2fd,stroke:#1565C0,stroke-width:2px
    classDef queueStyle fill:#fff3e0,stroke:#E65100,stroke-width:2px
    classDef tickStyle fill:#e8f5e9,stroke:#2E7D32,stroke-width:2px
    classDef execStyle fill:#fce4ec,stroke:#C2185B,stroke-width:2px
    classDef storageStyle fill:#f5f5f5,stroke:#616161,stroke-width:1px

    class CRON,WATCH sourceStyle
    class OFF,CE queueStyle
    class TP,TIME,DRAIN tickStyle
    class RUN,LIM execStyle
    class CJRUN,MARK,SKIP storageStyle
Was einen Tick startet
Einen Trigger wählen (einmalig):
OS-Cron — * * * * * vom webtrees-Root aus (siehe Installation).
systemd-Timer — die generierte Unit von der Modul-Admin-Seite.
watch-Daemon — der residente Prozess im Modul, der tick.php
alle 60 s neu startet und FPM-Worker-Recycling überlebt (Installation, die auch das Lifecycle-Diagramm des Daemons trägt).
Alle drei führen denselben Befehl aus: php modules_v4/cronjob/cli/tick.php cron:tick.
Was ein Tick tut
Guard — CliBootstrap::guard() antwortet 403, falls das Skript jemals über HTTP erreicht wird; danach lädt CliBootstrap::boot() webtrees + die Datenbank.
Offline-Check — wenn data/offline.txt existiert, wird der Tick komplett übersprungen, vor jedem Datenbankzugriff — z. B. während eines webtrees-Updates, wenn Schema und Code im Fluss sind.
Arbeit auswählen — zwei Quellen, in einem Durchlauf kombiniert:
zeitbasierte Jobs, deren next_run_at verstrichen ist (Cron-Zeitpläne, UTC); die fälligen Trigger werden relativ zum letzten Lauf berechnet (bzw. zur Erzeugung bei nie gelaufenen Jobs).
Event-Jobs — die cj_event-Warteschlange wird von der ältesten zuerst geleert, gekoppelt auf einen Lauf pro Ereignisnamen, innerhalb eines 60-Sekunden-Budgets. Event-Jobs erhalten den Ereignisnamen und das Payload über die Umgebungsvariablen CRONJOB_EVENT / CRONJOB_EVENT_PAYLOAD. Siehe Event-Pipeline.
Jeden Job isoliert ausführen — JobRunner validiert den Befehl (ein modules_v4/<module>/cli/<script>.php-Pfad oder einer der vier erlaubten Core-Befehle; höchstens 10 Argumente) und startet ihn als Kindprozess mit hartem Timeout (30–3600 s). Es werden nur die letzten 64 KB der Ausgabe erfasst; ein Job, der seinen Timeout erreicht, wird beendet (proc_terminate) und als Exit -9 gemeldet.
Protokollieren — jeder Lauf wird in cj_run geschrieben (Status, Exit-Code, Dauer, der auslösende Trigger, erfasste Ausgabe) — das ist die Ausführungshistorie. Event-gesteuerte Läufe werden zusätzlich über cj_event_run verknüpft.
Marker — der Tick schreibt data/cronjob/tick.last. Ist dieser Marker älter als 300 s, meldet das Modul sich im Admin-Status als tick_stale.
Manuelle Ausführung
Den Tick kann man auch manuell ausführen — --dry-run, --job=<name>, --strict und --full-output sind auf der Seite CLI-Skripte beschrieben. Achtung: --full-output kann personenbezogene Daten offenlegen — nur verwenden, wenn der Ausgabeort vertrauenswürdig ist.
1.4 - Ereignisse
Ereignisgesteuerte Jobs, Webhooks, Pseudo-Events und Route-Events
flowchart TD
    subgraph Sources["📡 Event-Quellen"]
        WH["`🔗 Webhook<br/>**GET + Token**`"]
        DC["`📞 Direkter Aufruf<br/>**EventQueue::push**`"]
        PE["📋 Pseudo-Events<br/>Log-Tabelle-Poller"]
        RE["🔀 Route-Events<br/>POST auf mutierende Routes"]
    end

    subgraph Queue["⏳ Queue"]
        CE[("`📦 cj_event<br/>**DB-Warteschlange**`")]
    end

    subgraph Tick["`⏱ Tick *(every 60 s)*`"]
        MATCH["Events matchen<br/>coalesced: 1 per name"]
        BUDGET["`⏲ **60 s** Wall-Clock-Budget`"]
    end

    subgraph Execution["⚙ Ausführung"]
        JOB["`Job-Skript<br/>child process via **proc_open**`"]
        ENV["🌐 CRONJOB_EVENT<br/>CRONJOB_EVENT_PAYLOAD"]
    end

    subgraph Storage["💾 Speicherung"]
        RUN[("cj_run<br/>Laufverlauf")]
        ER[("cj_event_run<br/>Verknüpfung")]
    end

    WH --> Queue
    DC --> Queue
    PE --> Queue
    RE --> Queue
    CE --> Tick
    MATCH --> BUDGET
    BUDGET --> JOB
    JOB --> ENV
    JOB --> RUN
    JOB --> ER

    classDef sourceStyle fill:#e3f2fd,stroke:#1565C0,stroke-width:2px
    classDef queueStyle fill:#fff3e0,stroke:#E65100,stroke-width:2px
    classDef tickStyle fill:#e8f5e9,stroke:#2E7D32,stroke-width:2px
    classDef execStyle fill:#fce4ec,stroke:#C2185B,stroke-width:2px
    classDef storageStyle fill:#f5f5f5,stroke:#616161,stroke-width:1px

    class WH,DC,PE,RE sourceStyle
    class CE queueStyle
    class MATCH,BUDGET tickStyle
    class JOB,ENV execStyle
    class RUN,ER storageStyle
Neben Zeitplänen kann ein Job durch ein Ereignis getriggert werden. Webtrees hat kein Ereignissystem, daher sind Ereignisse einfache DB-Zeilen (eine kleine cj_event-Queue), die der Tick einmal pro Minute leert. Ein ereignisgesteuerter Job läuft für ein gequeuedes Ereignis, dessen Namen seinen Ereignisnamen entspricht — koalesziert: pro Tick wird höchstens das neueste Ereignis pro Namen geleert (ein Lauf pro Namen pro Tick), und ältere ausstehende Duplikate des Namens werden verworfen — eine Flut identischer Events queue nie eine Flut von Job-Läufen (Job-Skripte sind per Konvention idempotent/inkrementell).
Benennungsschema (analog zu Job-Namen). Ereignisnamen sind Slugs (a-z 0-9 _ -, max. 64 Zeichen insgesamt), optional namespaced <domain>:<slug>:
Form
Bedeutung
einfacher Slug (z.B. index-dirty)
eigene Events — Webhook oder direkter EventQueue::push()
cronjob:<slug>
eingebaute Pseudo-Events (Log-Tabelle-Poller)
_route:<slug>
Route-getriggerte Events (siehe unten)
<module>:<slug>
von einem Modul angekündigte Events (siehe “Events ankündigen”)
Ein Ereignis zu queueen hat vier Quellen:
Webhook (externe Systeme). GET den auf der Admin-Seite gezeigten Endpunkt (Abschnitt “Event webhook”): GET /module/_cronjob_/Event?event=<name>&data=<json> mit dem Token im X-Cronjob-Token-Header. data ist ein optionales JSON-Objekt, das mit dem Ereignis gespeichert wird. Der Endpunkt erfordert das Token, ist rate-limited (20/min pro Site) und akzeptiert nur Ereignisse, während das Modul aktiviert ist. Es ist ein GET, kein POST: webtrees lehnt POSTs ohne Session-CSRF-Token ab, den ein externer Aufrufender nicht senden kann.
Direkter Aufruf (eigene Module). Aus PHP-Code in einem anderen Modul: \Schwendinger\Webtrees\Module\Cronjob\Services\EventQueue::push('index-dirty', ['tree' => 'X']); — dies erfordert, dass das Cronjob-Modul installiert ist; schützen Sie es mit class_exists('Schwendinger\Webtrees\Module\Cronjob\Services\EventQueue').
Pseudo-Events (eingebaute Poller). Webtrees hat keinen Event-Bus, daher werden Core-Aktionen (Logins, fehlgeschlagene Logins, Logouts, Datensatz-Edits, Fehler, Suchen) durch Polling der webtrees-Log-Tabelle beobachtet. Aktivieren Sie den angebotenen cronjob:pseudo-events-Job und das Modul liest die neuen Log-Einträge höchstens alle 5 Minuten, wobei pro Eintrag ein Event gequeued wird.
Route-Events (eingebaut, request-getriggert). Ein kuratierter Satz mutierender Editor-Routes unter /tree/{tree}/ (Record-spezifische Routes mit {xref} im Pfad, plus eine kleine Tree-Level-Allowlist) queue sein Ereignis sofort, direkt in der Anfrage, die die Änderung vorgenommen hat.
Der Tick gleicht jedes ausstehende Ereignis mit den aktivierten Jobs ab, die einen Ereignis-Trigger für diesen Namen tragen (ein Job kann mehrere Ereignis-Trigger haben oder keiner), führt sie aus und markiert dann das Ereignis als verarbeitet (einmal verbraucht — auch bei Fehler, damit ein fehlerhafter Job dasselbe Ereignis nicht ewig neu ausführt). Der Drain ist begrenzt: er nimmt das neueste Ereignis pro Namen (Koaleszierung, siehe oben) und stoppt nach einem 60-s-Wall-Clock-Budget, damit eine gesättigte Queue den Rest des Ticks nicht verhungern lässt — die verbleibenden Events setzen einfach mit dem nächsten Tick fort. Jeder verbrauchende Lauf wird zusätzlich über die cj_event_run-Kreuztabelle mit dem Ereignis verknüpft (ein Ereignis kann mehrere Jobs triggern), und die Ausführungshistorie zeigt, welches Ereignis einen Lauf ausgelöst hat. Verarbeitete Events werden nach 7 Tagen gelöscht (ihre cj_event_run-Links werden per FK-Cascade entfernt); Events ohne passenden Job werden verworfen, damit die Queue nicht wächst.
Ereignis-Payload im Kindprozess. Event-Läufe übergeben das Ereignis dem Job-Skript über die Prozessumgebung (das argv ist für die statischen, strikt validierten Argumente des Jobs reserviert):
Variable
Gesetzt bei
Wert
CRONJOB_EVENT
jeder Event-Lauf
der Ereignisname (dient zugleich als Marker “dies ist ein Event-Lauf”)
CRONJOB_EVENT_PAYLOAD
Event-Lauf mit nicht-leerem Payload
der Event-Payload als JSON (Route-Parameter, Log-Tabelle-Einträge, Webhook-data)
$event= getenv('CRONJOB_EVENT'); // false bei Zeitplan-/manuellen Läufen
$payload= json_decode((string) getenv('CRONJOB_EVENT_PAYLOAD'), true) ?: [];
$xref=$payload['xref'] ??''; // z.B. von einem _route:* Event
Variable nicht vorhanden = kein Payload. Der Payload wird beim Queueen auf 4000 Bytes gekürzt; ein JSON, das mitten durchgeschnitten ist, dekodiert nicht mehr, in dem Fall ist CRONJOB_EVENT_PAYLOADgar nicht gesetzt (nie leer, nie gebrochenes JSON).
Behandeln Sie den Payload als nicht vertrauenswürdige Eingabe — vor allem für Webhook-data, dessen Absender extern ist. Validieren Sie Werte (XREFs, Namen, …) vor der Verwendung.
Der Payload ist unabhängig vom Befehlstyp: Modul-CLI-Skripteund Core-Befehle (die die Variablen einfach ignorieren) funktionieren beide bei Event-Läufen.
Der Payload ist auch in der Ausführungshistorie (Ereignis-Detail) sichtbar, unabhängig vom Kindprozess.
1.4.1 - Pseudo-Events
Log-Tabelle-Polling
Webtrees hat keinen Event-Bus, daher werden Core-Aktionen (Logins, fehlgeschlagene Logins, Logouts, Datensatz-Edits, Fehler, Suchen) durch Polling der webtrees-Log-Tabelle (app/Log.php, Tabelle log) detektiert und pro neuem passenden Log-Eintrag ein Ereignis ausgelöst. Es ist standardmäßig deaktiviert: nichts läuft, bis der angebotene cronjob:pseudo-events-Job aktiviert wird.
Eingebaute Events (ein cj_event pro neuer Log-Zeile, Payload = die Zeile):
Ereignis
Log-Filter (log_type, Nachricht-Präfix)
Feuer bei
cronjob:log-auth-failed
auth, Login failed
ein Login-Versuch fehlgeschlagen (falsches Passwort, unbekannter Benutzer, nicht verifiziert, nicht genehmigt, keine Session-Cookies)
cronjob:log-auth-login
auth, Login:
ein Benutzer eingeloggt
cronjob:log-auth-logout
auth, Logout:
ein Benutzer ausgeloggt
cronjob:log-error
error, –
eine Ausnahme erfasst und geloggt (die Nachricht ist der Trace)
cronjob:log-edit-update
edit, Update:
ein Datensatz aktualisiert (GedcomRecord::updateRecord())
cronjob:log-edit-delete
edit, Delete:
ein Datensatz gelöscht (GedcomRecord::deleteRecord())
cronjob:log-search
search, –
eine Suche ausgeführt (eine Log-Zeile pro durchsuchtem Baum)
Payload:log_id, log_time, log_message (auf 250 Zeichen gekürzt, UTF-8-safe) plus gedcom_id / user_id, wenn die Log-Zeile sie trägt. Die Nachrichten-Präfixe sind die hartkodierten englischen Strings des aktuellen Cores; ein Core-Update, das sie ändert, stoppt das passende Ereignis still (kein Fallback per Design) — die Event-Katalog-Beschreibungen und die test-pseudo-events-Suite fixieren die aktuelle Zuordnung.
So läuft es
Ein Trigger, ein Cooldown. Die Detektion läuft nur vom angebotenen cronjob:pseudo-events-Job (*/5 * * * * per Default), im Kindprozess des Ticks — isoliert von jeder Web-Anfrage und durch den Job-Timeout begrenzt, sodass ein schwerer Detektor nie eine Page-Load blockieren oder verlangsamen kann. Ein 5-Minuten-Cooldown (ein data/ mtime-Marker) plus ein Lock halten wiederholte Läufe günstig und idempotent; der Cooldown begrenzt auch einen häufigeren Job-Cron.
Vom Job aktiviert, pro Ereignis gated. Das Aktivieren des cronjob:pseudo-events-Jobs schaltet die Detektion ein (es gibt keinen separaten Schalter — der Tick führt nur aktivierte Jobs aus). Ein Detektor, dessen Ereignis kein aktiver ereignisgesteuerter Job abhört, wird komplett übersprungen — keine Abfrage, kein Push.
Checkpoint + Backpressure. Jeder Detektor erinnert sich an die höchste log_id, die er verarbeitet hat (Statusdatei). Höchstens 200 Zeilen werden pro Lauf pro Detektor ausgelöst; der Checkpoint rückt nur bis zur letzten ausgelösten Zeile vor, sodass eine Flut über mehrere Läufe abgearbeitet wird — kein Datenverlust, nur Latenz.
Baseline beim ersten Lauf. Die erste Detektion erfasst nur die aktuelle max log_id und löst nichts aus, sodass das Aktivieren des Jobs nicht rückwirkend auf bestehende Daten feuert. (Erneutes Abhören eines zuvor nicht abgehörten Events holt seinen Backlog nach, begrenzt wie oben.)
Reset, nicht neu feuern, bei Tabellenschrumpfung. Wenn die Tabelle unter einen Checkpoint schrumpfte (TRUNCATE / DB-Restore — einfache Zeilend deletions können das nicht, MySQL Auto-Increment läuft nach Deletes weiter), baselined der Detektor still neu.
Offline-sicher & isoliert. Übersprungen, während data/offline.txt existiert; ein kaputter Detektor bricht nie die anderen; die Detektion ist serialisiert (flock) und der Status wird atomar nach data/cronjob/pseudo-events.json persistiert.
Die Log-Tabelle ist die Quelle der Wahrheit: unter einer Flut führt die Koaleszierung des Ticks einen Job einmal pro Ereignisnamen pro Tick mit dem neuesten Payload aus — ältere Zeilen werden nicht neu zugestellt, aber sie bleiben in der Log-Tabelle, und log_id im Payload ermöglicht einem Job, der Vollständigkeit braucht, den Bereich selbst neu zu lesen.
Wenn ein Ereignisname verschwindet, markiert die Admin-Tabelle solche Trigger mit dem unknown event-Badge.
Detektierte Events gehen in dieselbe cj_event-Queue wie Webhooks und werden vom normalen Event-Drain des Ticks konsumiert. Um darauf zu reagieren, erstellen Sie einen ereignisgesteuerten Job, dessen Ereignisname passt (z.B. bei cronjob:log-auth-failed Alarm, bei cronjob:log-edit-update neu indexieren).
1.4.2 - Route-Events
request-getriggert
Ein ergänzender, sofortiger Detektionsmechanismus: anstatt Zustand nach Zeitplan zu pollen, beobachtet das Modul die HTTP-Anfrage selbst. Wenn eine Anfrage an eine abgebildete mutierende Route erfolgreich bearbeitet wurde (2xx/3xx), queue sie das passende Ereignis in dieselbe cj_event-Queue — ein abhörender Event-Job reagiert dann beim nächsten Tick (~60 s), ohne Polling-Latenz.
Welche Routes abgebildet sind — zwei Regeln, beide abgeleitet aus der live webtrees-Routentabelle. Gemeinsame Voraussetzungen: Pfad beginnt mit /tree/{tree}/, der Handler ist im webtrees-Request-Handler-Namespace (RequestHandlers in 2.2.6, Controllers in 2.3), und die Anfrage ist eine POST-Mutation. In 2.2.6 wird dies bei der Abbildung erzwungen (GET-Seiten-Routes werden nicht abgebildet); in 2.3 trägt die Route keine HTTP-Methode, daher erfolgt die POST-Prüfung zur Auslösezeit und das GET-Formular-Load derselben Route wird ignoriert.
Record-Routes (regelbasiert — Core-Updates werden automatisch übernommen): der Pfad enthält {xref} (den Ziel-Datensatz) und der Handler-Klassenname beginnt mit Edit, Delete, Add, Create, Link, Paste, Reorder oder Pending. Der Ereignisname ist das dritte Pfad-Segment, namespaced _route:<segment>; wenn mehrere abgebildete Routes ein Segment teilen (delete, edit-raw, accept, reject), werden die folgenden Pfad-Parameter angehängt, Bindestrich-getrennt.
Tree-Level-Routes (kleine kuratierte Allowlist): die signifikanten baumweiten Mutationen, die kein {xref} in der URL tragen (Import, Merge, Renumber, …). Jeder Allowlist-Eintrag hat einen expliziten Ereignisnamen. Neue baumweite Mutationen in einem Core-Update brauchen ein Modul-Update (die Record-Route-Regel bleibt voll automatisch).
Insgesamt 38 Events (27 Record-Routes + 11 Tree-Level-Routes). Der Payload enthält immer tree (ID) + tree_name plus alle erkannten Route-Parameter. Record-Routes (mit {xref}) tragen zusätzlich change_pending (bool): ob die Änderung nach dieser Anfrage noch in der change-Tabelle aussteht (die Auto-Akzept-Präferenz des Benutzers ist aus) oder bereits angewendet (Auto-Akzept an). Eine ausstehende Änderung wird angewendet, wenn ein Admin sie akzeptiert — was ihre eigenen _route:accept*-Events feuert. Tree-Level-Routes schreiben direkt (keine change-Zeilen) und tragen kein solches Flag.
Breaking Change (diese Version). Record-Routes ohne{xref} in der URL — alle _route:create-*-Events plus _route:add-unlinked-individual — werden nicht mehr abgebildet: sie tragen keinen Ziel-Datensatz. Jobs, die auf diese Events hören, feuern nie wieder; die Admin-Tabelle markiert solche Trigger mit einem unknown route event-Badge (eine generische Prüfung aller _route:*-Trigger aller Jobs gegen die live Map), sodass das Umrichten sichtbar statt still ist.
_route:accept* / _route:reject* feuern, wenn eine ausstehende Änderung akzeptiert oder abgelehnt wird — die Akzeptierung einer ausstehenden Löschung ist der Moment, in dem der Datensatz tatsächlich entfernt wird.
So funktioniert es
Doppelt gated, standardmäßig aus. Ein Event feuert nur, während der Admin-Schalter “Route-Events” (Events-Abschnitt) an ist und mindestens ein aktiver ereignisgesteuerter Job auf diesen Ereignisnamen hört. Eine nicht abgebildete Anfrage kostet nichts (eine In-Memory-Suche); nur eine erfolgreiche Anfrage auf einer abgebildeten Route macht zwei winzige indexierte DB-Lesevorgänge.
Transaktional. Der cj_event-Insert läuft in der gleichen DB-Transaktion wie die Mutation (das Modul-Middleware sitzt innerhalb der webtrees-Request-Transaktion), damit das gequeue Event mit der Änderung zusammen committet oder zurückgerollt wird — kein Drift, kein Doppel-Feuer bei fehlgeschlagenem Speichern.
Blockiert nie. Die Detektion läuft nach dem Handler, ist exceptions-umhüllt und kann die Antwort nie verändern.
Robust gegenüber Core-Upgrades. Die Map wird aus der Routentabelle neu aufgebaut (geschlüsselt nach Handler-Klassen-Strings, kein ::class), sodass ein umbenannter/entfernter Handler einfach aufhört zu matchen statt zu fatale. Wenn die Routentabelle nicht verfügbar ist (z.B. CLI), hält eine statische Fallback-Map mit der Note-Route den Piloten am Laufen. Die Record-Route-Regel ist voll automatisch; nur die kleine Tree-Level-Allowlist ist kuratiert (siehe oben), und Jobs, die auf ein nicht mehr existierendes Ereignis zeigen — ein entferntes Route-Event oder ein entferntes eingebautes Pseudo-Event — werden in der Admin-Tabelle markiert (unknown event-Badge).
Um darauf zu reagieren, erstellen Sie einen ereignisgesteuerten Job, dessen Ereignisname passt (z.B. _route:update-record) und aktivieren Sie den “Route-Events”-Schalter. Beachten Sie die Überlappung mit den cronjob:log-edit-update / cronjob:log-edit-delete-Pollern: jede Record-Edit/Delete wird auch in die Log-Tabelle geschrieben, sodass das passende Log-Event beim nächsten Poll ebenfalls folgt — wählen Sie den Mechanismus, dessen Latenz/Präzision zum Job passt (Route-Events sind quasi-sofort und pro Objekt präzise, und tragen change_pending; Log-Poller hängen ~5 min hinterher, fangen aber auch Änderungen außerhalb der Web-UI).
1.5 - Howto
Wie können andere benutzerdefinierte Module dieses Cronjob-Modul nutzen?
Es können Informationen zum Status des Dienstes oder zu verwalteten Aufträgen abgefragt werden.
Außerdem ist es möglich, eigene CLI-Skripte zu registrieren, die von diesem Dienst verwaltet und ausgeführt werden sollen. Einzelheiten können den folgenden Abschnitten entnommen werden.
1.5.1 - Service API
Nutzung des Cronjob-Dienstes aus anderen Modulen
Benachbarte Module fragen den Status des Moduls über eine stabile, schreibgeschützte Schnittstelle (CronjobService) ab, anstatt auf dessen interne Dienste zurückzugreifen. Überprüfen Sie zunächst die Verfügbarkeit –
das Modul ist möglicherweise nicht installiert, und die Klasse kann nur automatisch geladen werden, wenn die Datei
module.php
geladen wurde:
<?php
use Schwendinger\Webtrees\Module\Cronjob\Services\CronjobService;
if (class_exists(CronjobService::class) && CronjobService::isFunctional()) {
$status= CronjobService::jobStatus('mymodule:backup'); // null = unknown job
$age= CronjobService::lastTickAge(); // seconds since last tick
$listened= CronjobService::listenedEvents(); // event name => job names
}
runJobNow($name) (wird beim nächsten Tick in die Warteschlange gestellt), pushEvent($name, $payload) (Ereigniswarteschlange)
Vertrag: Schreibgeschützte Methoden lösen niemals einen Fehler aus, wenn das Schema fehlt (sichere Standardwerte),
Beschreibungen sind Quelltext-Strings (werden niemals vorab übersetzt), und lastRun() schließt bewusst
die Job-Ausgabe aus, da diese personenbezogene Daten enthalten kann.
1.5.2 - Selbst-Registrierung
Wie andere Module ihre Jobs dem Cronjob-Modul anbieten
Andere Module können ihre geplanten Jobsanbieten, damit sie in der Admin-UI erscheinen, ohne dass jemand die Registry manuell editiert. Dazu können zwei Wege beschritten werden (ein Modul kann beide verwenden) - beide werden automatisch bei jedem Tick entdeckt, wobei dies nur für aktivierte Module gilt:
Marker-Methode
getCronJobs(): array in der Modul-module.php
-Klasse, die dasselbe Format zurückgibt. Entsprechend: getModuleEvents(): array, getModuleCommands(): array.
Manifest-Datei (empfohlen)
Bereitstellung einer Datei im Modulverzeichnis (modules_v4/<module>/cron-jobs.php), die ein Array von Job-Spezifikationen zurückgibt:
Übersetzbare title / description-Texte in einem Manifest sollten in MoreI18N::translate() (Identitäts-Markierung) gesetzt werden,
damit xgettext sie aufnimmt — die Übersetzung erfolgt zur Render-Zeit, nie beim laden des Manifests.
Job-Spezifikations-Felder
Schlüssel
Erforderlich
Bedeutung
name
ja
Slug a-z 0-9 _ -, max. 64; gespeichert als <module>:<name>
title
nein
menschlicher Name (Default = name)
triggers
ja
Liste von Trigger-Einträgen, mindestens einer
command_type
ja
module oder core
command
ja
der Befehl
args
nein
einfache Option/Wert-Tokens
enabled
nein
Default false — entdeckte Jobs werden deaktiviert erstellt
timeout_sec
nein
Default 300, Bereich 30 - 3600
Sobald ein entdeckter Job eingefügt ist, ist er unter Admin-Kontrolle: spätere Ticks überschreiben ihn nie.
Ereignisse ankündigen
Dasselbe Manifest kann auch Ereignisse ankündigen, die das Modul auslöst (damit sie im
Ereignis-Katalog und in den Vorschlägen des Job-Formulars erscheinen). Anstelle einer
einfachen Job-Liste kann das Manifest ein assoziatives Array mit optionalen jobs- und
events-Listen zurückgeben (eine einfache Liste bedeutet weiterhin „nur Jobs"):
<?php
// modules_v4/linkenhancer/cron-jobs.php
declare(strict_types=1);
return [
'jobs'=> [
[
'name'=>'link-index',
'triggers'=> [
['type'=>'time', 'cron'=>'*/30 * * * *'],
// A job may combine several triggers:
// ['type' => 'event', 'event' => 'linkenhancer:index-dirty'],
],
'command_type'=>'module',
'command'=>'modules_v4/linkenhancer/cli/build-link-index.php',
],
],
'events'=> [
['name'=>'index-dirty', 'description'=>'The link index is out of date.', 'payload'=> ['tree']],
],
];
Ein angekündigtes Ereignis ist namespaced <module>:<name> (wie die angebotenen Job-Schlüssel).
Der event-Wert eines Ereignis-Triggers, der keinen Doppelpunkt trägt, wird automatisch
namespaced <module>:<event>; ein Name, der bereits einen Doppelpunkt hat (z.B.
cronjob:log-edit-update), bleibt unverändert.
Slug a-z 0-9 _ - (gespeichert als <module>:<name>)
description
nein
wird im Ereignis-Katalog angezeigt (Übersetzungsschlüssel, max. 255)
payload
nein
Liste von Payload-Parameter-Namen (max. 8), wird im Katalog angezeigt
Befehle ankündigen
Dasselbe Manifest kann auch Befehle ankündigen, die ein Job ausführen kann, mit ihren
verfügbaren Parametern. Eine einfache Manifest-Liste bedeutet weiterhin „nur Jobs"; um
Befehle anzukündigen, gibt das Manifest die assoziative Form mit einer commands-Liste zurück:
// modules_v4/linkenhancer/cron-jobs.php
declare(strict_types=1);
return [
'jobs'=> [ /* … */ ],
'commands'=> [
[
'command'=>'modules_v4/linkenhancer/cli/build-link-index.php',
// 'command_type' => 'module', // optional - derived from the command value
'description'=>'Rebuild the link index incrementally.',
'params'=> [
['name'=>'--limit', 'optional'=>true, 'default'=>'5000', 'description'=>'max records per run'],
['name'=>'--since', 'optional'=>true, 'description'=>'only changes since this timestamp'],
],
],
],
];
Command-Spezifikations-Felder
Schlüssel
Erforderlich
Bedeutung
command
ja
ein modules_v4/…/cli/*.php-Pfad oder ein erlaubter Core-Befehl, max. 255
command_type
nein
module oder core (wird bei weggelassenem Wert aus command abgeleitet)
description
nein
wird im Befehl-Katalog angezeigt (Übersetzungsschlüssel, max. 255)
params
nein
Liste von Parameter-Deskriptoren (max. 8)
Jeder Parameter-Deskriptor hat name (das Option-Token, z.B. --limit), optional
(Bool, Default true — auf false setzen für eine erforderliche Option), default
(ein optionaler Wert) und description (optional). Entsprechende Marker-Methode:
getModuleCommands(): array (dasselbe Command-Spec-Format).
Kurations-Regel: Ein Modul, das Befehle ankündigt, kuratiert seine eigene Befehlsliste —
die glob-basierte Entdeckung listet seine Skripte nicht mehr auf, sodass interne Skripte
(tick.php
, watch.php
, wrap.php
, smoke-job.php
) nicht als Job-Befehle angeboten
werden. Ein Modul, das nichts ankündigt, fällt auf die glob-Entdeckung seiner
cli/-Skripte zurück (abwärtskompatibel).
1.6 - CLI-Skripte
Command-Line-Skripte und Wartung
Skripte
php modules_v4/cronjob/cli/tick.php # alle fälligen Jobs ausführenphp modules_v4/cronjob/cli/tick.php --dry-run # anzeigen, was ausgeführt würdephp modules_v4/cronjob/cli/tick.php --job=<name> # einen bestimmten Job jetzt ausführenphp modules_v4/cronjob/cli/tick.php --strict # Exit 1 wenn ein Job fehlgeschlagen istphp modules_v4/cronjob/cli/tick.php --full-output # vollständige Job-Ausgabe echo (Debugging!)php modules_v4/cronjob/cli/watch.php # Watch-Daemon starten
Exit-Codes: 0 = Tick lief (Job-Fehler werden in der DB protokolliert), 1 = Umgebungsproblem oder (mit --strict) mindestens ein Job fehlgeschlagen.
Log-Hygiene: stdout trägt nur Summary-Zeilen. Die vollständige Job-Ausgabe liegt in der Ausführungshistorie (nur Admin). --full-output niemals in einen weltlesbaren Ort umleiten.
Für die Fehlersuche unterstützt das tick.php
Skript auch die Parameter -v und -vv, damit die Konsolen-Ausgabe ausführlicher ausfällt.
Acceptance-Test
php modules_v4/cronjob/cli/smoke-job.php # zeigt ok, Exit 0php modules_v4/cronjob/cli/smoke-job.php --sleep=10# lebt 10 s (Timeout-Test)
Erstellen Sie einen Job mit Befehl modules_v4/cronjob/cli/smoke-job.php, klicken Sie Jetzt ausführen, warten Sie eine Minute — die Verlauf-Seite sollte eine grüne ok-Zeile zeigen.
Konventionen für Job-Skripte
Neue Job-Skripte in anderen Modulen müssen diese Konventionen einhalten:
Ort modules_v4/<module>/cli/, aufgerufen als php modules_v4/<module>/cli/<script>.php
Beginnen mitrequire autoload.php und CliBootstrap::guard()
Idempotent und inkrementell (--limit, --since), batched
Exit-Code 0 bei Erfolg
Keine interaktive Eingabe; alles über CLI-Optionen
Template-Dateien sind mit _ Präfix versehen (von der Job-Entdeckung ausgeschlossen)
Eigene CLI-Skripte können leicht auf folgende Weise begonnen werden:
einer Vorlage:_template-maintenance.php
– diese in das Verzeichnis cli/ des eigenen Moduls kopieren, umbenennen und entsprechend anpassen
oder, falls das Modul bereits von Cronjobs abhängt, kann dieser Bootstrap-Vorgang stattdessen
an den gemeinsamen CLI-Wrapper delegiert werden
Wartungsskripte schreiben
Die Vorlage verwenden
_template-maintenance.php
ist eine Vorlage zum Kopieren und Einfügen für länger laufende Wartungsaufträge. Die Konventionen:
SAPI-Guard: Jedes Skript beginnt mit CliBootstrap::guard() – das Verzeichnis ist über eine URL erreichbar, der Guard gibt den Status 403 zurück, anstatt das Skript auszuführen.
Bootstrap: Verwende CliBootstrap::boot() – die zentrale CLI-Bootstrap-Sequenz (App-Bootstrap, i18n, Konfiguration, Datenbank) mit einem harten Fehler bei fehlender Konfiguration oder fehlender Datenbankverbindung.
Argumente: einfaches $argv (--limit=N, --help).
Sperre: flock() auf data/<module>/<name>.lock, damit sich überlappende Cron-Läufe nicht kollidieren; eine gehaltene Sperre ist kein Fehler (Beendigungscode 0).
Idempotente Batches: Gestalten Sie den Job so, dass ein Lauf in etwa 5–10 Minuten abgeschlossen ist und der nächste Lauf dort fortgesetzt wird, wo der letzte aufgehört hat.
Protokollierung: einfache Zeilen in der Standardausgabe (Cron-E-Mail / Protokolldatei). Geben Sie niemals personenbezogene Daten aus – Zähler und XREFs, niemals Namen.
Exit-Codes: 0 = ok (einschließlich „nichts zu tun“, „Sperre gehalten“), 1 = Fehler.
CLI-Wrapper verwenden
Ein Job-Skript, das webtrees + Datenbank braucht, kann den Bootstrap an den gemeinsamen Wrapper des Cronjob-Moduls delegieren:
Payloadmodules_v4/<module>/cli/<name>.logic.php — die eigentliche Logik.
Stubmodules_v4/<module>/cli/<name>.php — worauf die Job-Zeile zeigt:
<?php
declare(strict_types=1);
$wrapper=__DIR__.'/../../cronjob/cli/wrap.php';
if (is_file($wrapper)) {
require$wrapper;
} else {
fwrite(STDERR, "cronjob module required for this job\n");
exit(1);
}
wrap.php
bootstrapt webtrees + DB und inkludiert dann das Payload (Geschwisterdatei mit .logic.php-Erweiterung). Der Payload-Pfad wird aus dem Entry-Skript abgeleitet, nie aus einem Argument genommen.
1.7 - Sicherheit
Sicherheitsmodell und Befehlsvalidierung
Nie eine Shell. Befehle werden via proc_open mit einem argv-Array ausgeführt.
Befehls-Whitelist.Modulskripte müssen modules_v4/<module>/cli/<script>.php entsprechen, existieren und sich in einem modules_v4/<module>/cli/-Verzeichnis auflösen. Core-Befehle sind auf die Read-only/Export-Allowlist beschränkt.
Argument-Validierung. Jedes Argument-Token muss eine einfache Option oder ein Wert sein — keine Shell-Metazeichen, keine Leerzeichen in Tokens, max. 10 Tokens.
Arbeitsverzeichnisse. Modulskripte laufen vom webtrees-Root; Core-Befehle laufen von data/.
Keine sensiblen Daten in stdout. Der Tick gibt nur Zusammenfassungen aus; die vollständige Ausgabe bleibt in der Ausführungshistorie (admin-only).
UI-Aktionen sind alle als *Admin* benannt (nur Admin, CSRF-geschützt).
Notaus-Schalter: Modul deaktivieren — der Tick tut dann nichts.
Der Tick ist Single-Instance (flock), und der Kindprozess eines Jobs wird nach dem Timeout hart getötet (SIGKILL).
Bündelung von Ereigniswarteschlangen. Eine Flut identischer Ereignisse wird zusammengeführt zu einem Joblauf.
Webhook-Token nur im Header. Das Token wird ausschließlich im X-Cronjob-Token-Header gesendet.
2 - LinkEnhancer
webtrees Custom-Modul: Querverweise, erweiterte Links, Markdown-Editor und kontextsensitive Hilfe
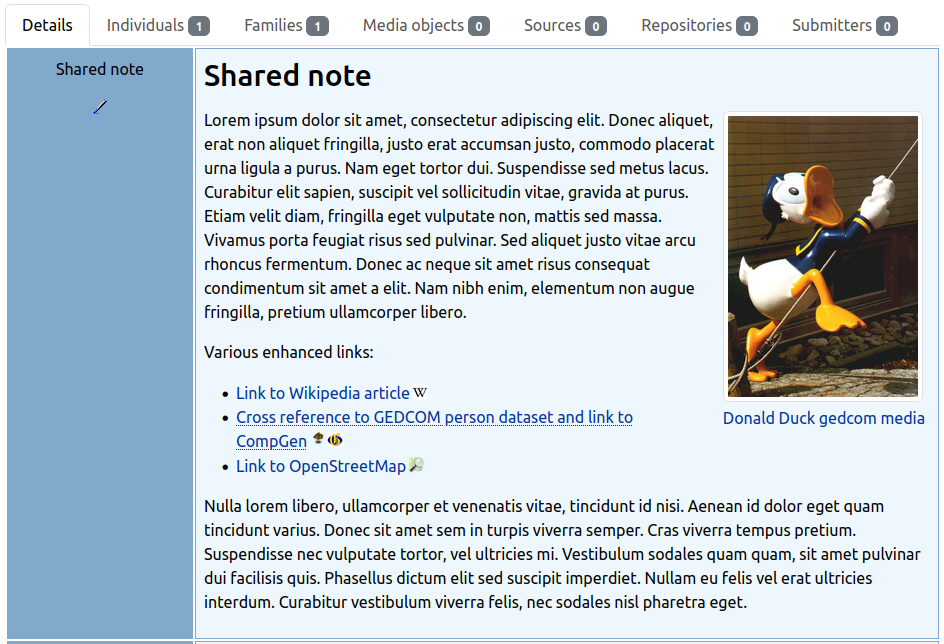
Notiz mit erweiterten Links und Bild aus Mediendatensatz
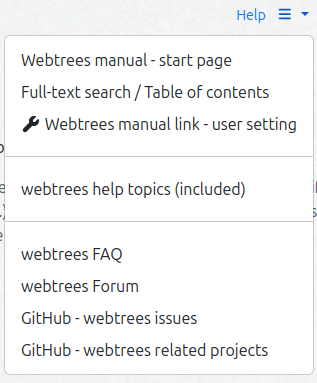
Seitentitel als Home-Link kleines Menü mit Hilfe-Link
Der Hauptzweck ist es Verknüpfungen zu Datensätzen in Stammbäumen zu vereinfachen. Dadurch müssen keine vollqualifizierten Links gespeichert werden, was die Portierbarkeit von GEDCOM-Daten einschränkt. Durch Verknüpfung von Notizen mit GEDCOM-Datensätzen (Personen, Familien, Quellen, usw.) wird das Geschichtenerzählen deutlich einfacher.
Support
Issues: Für Ideen oder beim Finden eines Bugs kann ein Issue erstellt werden.
Forum: Allgemeine webtrees-Unterstützung findet man im webtrees Forum.
2.1 - Einrichtung
Installation und Voraussetzungen
Was wird zum Installieren dieses Moduls benötigt und wie wird es korrekt eingerichtet.
2.1.1 - Voraussetzungen
Systemvoraussetzungen für das LinkEnhancer-Modul
Dieses Modul benötigt webtrees Version 2.2 oder 2.3
und hat dieselben Anforderungen wie webtrees#system-requirements.
Es wurde ursprünglich für Version 2.2.4 erstellt; seit LinkEnhancer 1.6.1 sollte es auch mit webtrees 2.3 funktionieren. Tests werden normalerweise mit eingebauten Themes und einigen anderen Custom-Modulen durchgeführt.
Tipp: Es wird empfohlen, das Cronjob-Modul ebenfalls zu installieren. Das erleichtert das Ausführen der CLI-Skripte zur Index-Wartung.
2.1.2 - Installation
Schritt-für-Schritt-Installationsanleitung
Über Custom Module Manager (empfohlen)
Installieren Sie Custom Module Manager für eine einfache und bequeme Installation von webtrees Custom-Modulen.
Öffnen Sie die Custom Module Manager-Ansicht in webtrees, wählen Sie “linkenhancer” aus und klicken Sie auf die “Install Module”-Schaltfläche.
Bei Aktivierung der ersten vier Grundfunktionen können weiter unten noch detailliertere Einstellungen vorgenommen werden. Auch gibt es zwei globale Einstellungen für Debugausgaben in der JavaScript-Konsole des Browsers und der Webserver-Fehlerlogdatei und man kann sich entscheiden, ob Links grundsätzlich in einem neuen Browsertab geöffnet werden sollen (je nach Grundfunktion differenzierte Einstellung ist auch möglich).
Nachfolgend die verfügbaren Optionen auf der Admin-Seite:
[1] Verbesserte Link-Unterstützung
Eigene externe Ziele
Hier zwei Beispiel-Einträge aus den vordefinierten Zielen zur Veranschaulichung des Prinzips, wie zusätzliche externe Ziele mit einem eigenen JavaScript-Objekt bereitgestellt werden können.
{
"fsft": {
name:'Family Search Tree - $ID',
url:'https://www.familysearch.org/tree/person/details/',
cname:'icon-fsft' },
"wp": {
name:'Wikipedia',
url: (id, title) => {
let parts = id.split('/');
if (parts.length <2) {
title = title +" - "+ options.i18n('syntax error') +"!";
return { url:'', title };
}
let subdomain = parts[0];
let article = parts.slice(1).join('/');
title =`${title} - `+decodeURIComponent(article) +` (${subdomain})`;
return { url:`https://${subdomain}.wikipedia.org/wiki/${article}`, title };
},
cname:'icon-wp',
help: [
{ n: options.i18n('wp-help1'), e:'de/Webtrees' },
{ n: options.i18n('wp-help2'), e:'en/Webtrees' },
{ n: options.i18n('wp-help3'), e:'other-subdomain/Webtrees' },
]
}
}
Erläuterung der Eigenschaften (die Syntax eines erweiterten Links: #@param-key=param-value):
key — der oben genannte Kurzname oder Query-Parameter-Schlüssel (param-key)
name — Titel oder Label, das als Link-Titel angezeigt wird; der Platzhalter $ID wird durch die gegebene ID (param-value) ersetzt
url — Service-URL, die aufgerufen wird; der Parameterwert / die gegebene Record-ID (param-value) wird ans Ende der URL angehängt. Es kann auch eine Funktion sein, die (id, title) akzeptiert und ein Objekt { url, title } zurückgibt.
cname — CSS-Klassenname(n), durch Leerzeichen getrennt
help — optionales Array von Objekten [{n:'', e:''},..] zur Veranschaulichung der Verwendung eines Nicht-Standard-Ziels durch Beispiele (in e), versehen mit Erläuterungstext (in n). Wird in der Markdown-Hilfe aufgelistet.
options.i18n ist eine Funktion, die von diesem Modul durchgereicht wird, um übersetzte Zeichenketten bereitzustellen.
Erforderliche CSS-Regeln am besten über das CSS-und-JS-Modul ergänzen. Eigentlich wird nur die Definition des Icons (Größe 30 x 30 Pixel reicht) als Hintergrundbild benötigt — referenziert als data: URLs. Zum Beispiel: .icon-whatever { background-image: url(...) }
[2] Markdown Verbesserungen
Wenn man als Entwickler den Markdown Editor (mde) auch auf Textareas auf den Bearbeitungsseiten anderer Custom-Module anwenden möchte, kann man dies mit dem MarkdownEditorActivationService tun (verfügbar seit v1.2.11 — Details siehe #101):
<?php
privatefunctiontoggleTinyMde(bool $enable, bool $force=false): void
{
$class="Schwendinger\\Webtrees\\Module\\LinkEnhancer\\Services\\MarkdownEditorActivationService";
if (Registry::container()->has($class)) {
/** @var MarkdownEditorActivationService $mde_service */$mde_service= Registry::container()->get($class);
$existingRule=$mde_service->getCustomRule(self::CUSTOM_TITLE);
if (
$force||$enable&&!$existingRule||!$enable&&$existingRule ) {
$mde_service->setCustomRule(
self::CUSTOM_TITLE, // module name as key
$enable? ["source-transcription-detail"] : [], // handler: route name
$enable? ["textarea[id$='_text']"] : [] // filter: querySelector
);
}
}
}
Dies funktioniert nur, wenn diese Funktion global aktiviert wurde und die Bearbeitungsseite mit einem Baum verbunden ist, der auch Markdown in seinen Notizen verwendet.
Im versteckten Textfeld unterhalb der Radiobuttons zum de-/aktivieren der Option “Markdown-Editor für Notizen-Texteingabefelder” lassen sich die registrierte Konsumenten durch Überfahren des Bereichs mit dem Mauscursor einsehen.
Bekannte Custom-Module, die diese Funktion nutzen:
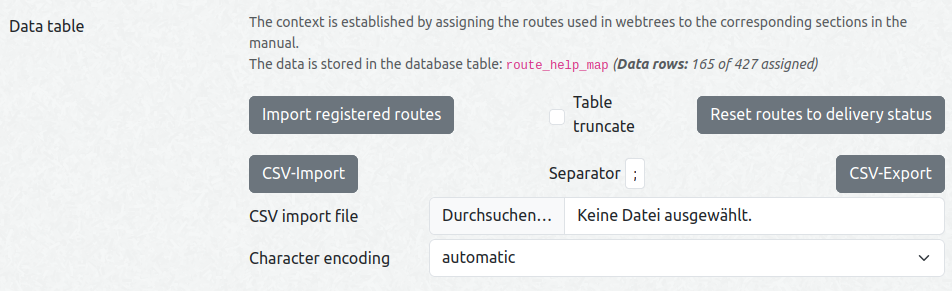
Es können auf Wunsch in webtrees registrierte Routes importiert werden. Dies erleichtert die Abdeckung individueller Custom-Modul-Konfigurationen.
Außerdem können Daten im CSV-Format importiert und exportiert werden, um Änderungen bequemer zu gestalten. Man kann den Trenner und für den Import die Zeichencodierung definieren (beim Export ist es immer UTF-8). Man kann auf einen Blick sehen, wie viele Datenzeilen in der Tabelle gespeichert sind und wie viele von ihnen eine URL zugewiesen haben.
Im Falle von Diskrepanzen kann die Kontext-Hilfe durch Aktivieren der Option “Ausgabe von Debug-Informationen auf der JS-Konsole” leichter angepasst werden. Dies liefert Informationen zur aktiven Route und, falls zutreffend, zu Datentabelle-Einträgen, die für die Zuordnung zum Hilfe-Thema gefunden wurden.
Route-zu-Hilfe-Zuordnung
Die Zuordnung von Routes zu Hilfe-Artikeln im Handbuch wird in der Datenbank-Tabellele_route_help_map gespeichert. Dieses Modul kommt mit vordefinierten Zuordnungsvorschriften. Wenn etwas fehlt oder man ein Problem findet, zögern Sie nicht dies mitzuteilen.
Technische Hintergrundinformationen folgen. Die Tabelle hat die folgenden Header (die Header, die in einer CSV-Datei für den Import erforderlich sind, sind mit !! markiert):
id: automatischer Schlüssel — nicht relevant, das Datenfeld wird nur verwendet, um die Identifizierung des Datensatzes beim Bearbeiten zu erleichtern.
path!!: Routenpfad — entspricht dem Pfad der webtrees Pretty-URLs
handler!!: entspricht in der Regel dem PHP-Klassennamen des Codes, der die Anfrage bearbeitet
method!!: Web-Anfragemethode (GET, POST, HEAD). Nur GET-Routes sind allgemein relevant für die Zuordnung zu Handbuch-Abschnitten.
extras!!: PHP-Klassennamen des Zugriffslevels (Fisharebest\Webtrees\Http\Middleware\Auth*)
subcontext!!: CSS-Selektor-String oder JSON-Objekt-String, um eine Komponente/ein Subkontext-Thema auf der angegebenen Seite zu adressieren
category: Zeichenkettenwert zum besseren Gruppieren von Datenzeilen; nur der Wert ‘generic’ hat eine besondere Bedeutung
order!!: beliebiger numerischer Sortierschlüssel, übereinstimmende Datenzeilen werden aufsteigend sortiert (Standardwert ist 10)
url!!: Pfad der URL zum webtrees Handbuch (wird mit der angegebenen GenWiki-Basis/Domänen-URL verkettet). Auch vollqualifizierte URLs zu anderen Web-Ressourcen sind möglich und unterstützt.
updated_at: Zeitstempel der letzten Aktualisierung — hilft bei der Identifizierung möglicherweise veralteter Datenzeilen
Wie wir in app/Http/Routes/WebRoutes.php sehen können, wo die Standard-webtrees-Routes definiert sind, sind für eine Route die folgenden Informationen erforderlich:
path
handler
method
Optional kann extras bereitgestellt werden. Wenn keines der vier oben genannten Felder gesetzt ist, wird die Datenzeile vom Seeder gefiltert. Beim Import werden category und order automatisch gesetzt, falls nicht gesetzt.
Um eine Erstklassen-Übereinstimmung mit der aktuellen Route zu erzielen, müssen diese vier Felder übereinstimmen.
Normalerweise ist es nur notwendig, GET-Routes einem Artikel zuzuordnen. Es gibt auch einige Redirect-Routes und ajax-Helfer-Routes (die Daten für Formsteuerungen bereitstellen), die ignoriert werden können.
Sonderfälle sind die paths, die mit /module/{module}/{action} oder /tree/{tree}/data-fix/{data_fix} beginnen: sie werden von einer integrierten Proxy-Klasse verarbeitet, die das Custom-Modul über ein Route-Attribut adressiert:
Für die Zuordnung einer solchen Route zu einem bestimmten Custom-Modul-Hilfe-Artikel wird der handler auf den oben genannten Route-Attributwert gesetzt (z.B. _vesta_classic_look_and_feel_). Für eine generischere Regel kann path auch leer sein (dann kann eine Regel für beide Fälle verwendet werden).
Fallback-Regeln für Zugriffslevel werden durch category='generic' und den spezifischen Auth-Klassennamen in extras abgeglichen.
In aufsteigender Reihenfolge wird die erste Regel mit subcontext = '' für den Top-Menü-Link ausgewählt. Wenn nichts anderes zutrifft, zeigt der Link auf die Startseite des Handbuchs.
Wenn aktiviert, können subcontext-Themen auf einer Seite mit einem zusätzlichen Hilfe-Link versehen werden. Man kann einen CSS-Selektor-String oder einen JSON-Objekt-String mit den folgenden Eigenschaften setzen:
p: Position des Popovers, optional (Default ist top, andere mögliche Werte: left, right, bottom)
f: CSS-Selektor/Filter-String (nur notwendig, wenn man das Popover an einer anderen Positionieren möchte) ODER
e: JavaScript-Ausdruck-String
Dies ist nützlich, wenn es Komponenten auf der Seite gibt, die detailliertere Informationen benötigen, als der Hilfe-Link im Top-Menü bietet (z.B. für Custom-Modul-Funktionen auf der Personenseite). Dieser Hilfe-Link wird in einem Popover angezeigt (weil ein zusätzlicher Link nicht immer in Bootstrap-Tabs, Akkordeon-Headern oder Menü-Titeln funktioniert).
Setzen Sie category='generic' für Regeln, die auf mehr als eine Seite anwenden sollen.
Inhaltsverzeichnis (TOC)
Dieses Modul lädt ein mehrsprachiges Inhaltsverzeichnis für das deutsche webtrees Handbuch von einem Remote-Feed (JSON-Dateien: Struktur, Sprachübersetzungen und Versions-Manifest). Die Daten werden lokal zwischengespeichert und automatisch aktualisiert:
On-the-fly: Wenn ein Benutzer die TOC-Seite aufruft und der Cache abgelaufen ist (24 h), prüft der Service das Feed-Manifest (version.json) auf hash-Änderungen pro Datei und lädt nur die geänderten Dateien neu herunter.
Proaktiv (cron): Der refresh-wthb-toc Cron-Job (täglich um 03:00 per Default) lädt alle Dateien herunter, unabhängig vom Cache-Zustand.
Auto-Aktualisierung-Schalter: Die Modul-Admin-Seite bietet einen “Auto-Aktualisierung”-Schalter für die TOC-Daten. Wenn deaktiviert, werden nur lokal zwischengespeicherte Daten ausgeliefert (keine HTTP-Downloads). Der Admin-Force-Refresh-Button und die CLI mit --force funktionieren trotzdem unabhängig vom Schalter. Tipp: Daten vor dem Deaktivieren aktualisieren, um sicherzustellen, dass die neueste Version zwischengespeichert ist.
CLI:
php modules_v4/linkenhancer/cli/refresh-wthb-toc.php              # Scope aus Modul-Einstellung
php modules_v4/linkenhancer/cli/refresh-wthb-toc.php --all        # alle verfügbaren Sprachen
php modules_v4/linkenhancer/cli/refresh-wthb-toc.php --lang=en,fr # bestimmte Sprachen
php modules_v4/linkenhancer/cli/refresh-wthb-toc.php --clear      # nur Cache leeren
php modules_v4/linkenhancer/cli/refresh-wthb-toc.php --force      # auch bei deaktivierter Auto-Aktualisierung
Während Auto-Aktualisierung ausgeschaltet ist, werden geplante Aktualisierungen übersprungen (der Cron-Lauf beendet sich mit Exit 0 ohne Arbeit). --force aktualisiert trotzdem (z.B. zur Vorbereitung der Reaktivierung), und --clear funktioniert unabhängig vom Schalter.
Externe Hilfe-Links
Das Modul enthält einige Standard-externe Hilfe-Links, die in JSON definiert sind — Array von Objekten mit den folgenden Mitgliedern:
title: Anzeigetext für den Link, kann auch HTML enthalten (String, Pflichtfeld), Sprache sollte en-US sein; für Standard-Link-Titel werden Übersetzungen bereitgestellt
self: falls gesetzt, ist Link-target_self (öffnet an Ort und Stelle), sonst _blank (beliebiger Typ, optional)
i18n: Titel mit benutzerdefinierter Übersetzung für gegebene Sprach-Tags überschreiben (Objekt, optional; Schlüssel sind Sprach-Tags, Werte sind übersetzte Titel)
Erklärung: Der Objektschlüsselname wird auf den Theme-Namen gesetzt, der abgeglichen werden soll, und der Zeichenkettenwert enthält eine oder mehrere CSS-Stilregeln. In diesem Beispiel haben wir eine Fallback-Regel mit dem Schlüssel *, die alle Themes abdeckt, es sei denn, es gibt einen spezifischen Schlüssel.
Theme colors ist ein Sonderfall, bei dem wir auch Paletten haben. Um diese Kombination zu adressieren, wird der Schlüssel auf theme name_palette name gesetzt. Der Schlüssel colors deckt alle Subthemes ab.
Aktivieren Sie einfach die Option “Ausgabe von Debug-Informationen auf der JS-Konsole”, um die korrekten Werte herauszufinden.
2.2 - Funktionen
Übersicht aller LinkEnhancer-Funktionen
2.2.1 - Erweiterte Links
Querverweise und LinkEnhancer-Links in GEDCOM-Datensätzen
Webtrees ersetzt XREFs wie @I2@ in Notizen durch einen Querverweis und dessen Anzeige-Name — aber das ist nicht sehr flexibel. Man kann den Anzeigenamen nicht festlegen, was bedeutet, dass bei einem Fehler (durch XREF-Umnummerierung oder Tippfehler) die Auflösung des Querverweises nicht leicht oder gar nicht möglich ist.
Tipp: Das Custom-Modul webtrees-mitalteli-show-xref kann helfen, die XREF- und UID-Referenz von Personendatensätzen zu finden. Einige UIDs (38 Zeichen Länge) werden von webtrees in der Standardansicht automatisch verkürzt — dieses Modul zeigt die unveränderten UIDs.
Funktionsweise
Die erweiterte Links-Funktion ist per JavaScript implementiert und sucht in der gerenderten webtrees-Ausgabe nach <a>-Tags, deren href-Attribut mit #@ beginnt. Dadurch können Links in Markdown und HTML-Markup verarbeitet werden. Da die Verarbeitung im Browser auf Client-Seite erfolgt, wird die Existenz der Querverweis-Datensätze nicht im Voraus geprüft. Fehler treten erst auf, wenn der Link angeklickt wird (z.B. wenn der Zugriff auf die Ressource eingeschränkt ist).
Als Bonus können mit einer Link-Definition verschiedene Ziele adressiert werden, wobei der Querverweis immer der erste Link ist (falls gesetzt) und die anderen nur durch angehängte klickbare Icons dargestellt werden.
Vordefinierte externe Ziele
Die Parameter-Schlüssel sind in Klammern aufgeführt:
Jeder Parameter-Schlüssel kann mehrfach angegeben werden — aber man sollte es der Klarheit halber nicht übertreiben.
Zusätzliche externe Ziele können auf der Admin-Seite konfiguriert werden.
Syntax
Markdown: Ein erweiterter Link sieht so aus: [Link-Anzeigename](#@param1¶mN), sodass ein oder mehrere Ziele auf einmal adressiert werden können. Für Querverweise in webtrees wird eine Datensatz-Referenz erwartet (REF kann die XREF oder eine UID sein):
wt=@REF@ oder wt=@REF@andererbaum — Standard-Link, Zugriff auf die Datensatzseite über Redirect-URL
wt=n@REF@ — Legacy-Link mit gegebenem Record-Typ (hier: zu einer Notiz mit REF im aktuellen Baum)
Verfügbare Record-Typen: i=Person, f=Familie, s=Quelle, r=Depot, n=Notiz, l=geteilter Ort
wt=i@REF@andererbaum+dia — Link zum Personentyp mit REF aus Baum “andererbaum” und zusätzlich Link zum Interaktiven Sanduhrdiagramm dieser Person
HTML: Dasselbe gilt für HTML-Links: <a href="#@wt=i@I1@">Link-Anzeigename</a>
Dies ist auch in Kombination mit der Namensschild-Funktion des Vesta Classic Look & Feel Moduls im HTML-Snippet-Feld verwendbar: <a href="#@fsft=<ref/>"></a> zum Verlinken eines Datensatzes im Family Search Family Tree. Es ist auch möglich, solche Links in News-Artikeln von Tyweds news-menu Modul oder in FAQ-Artikeln einzubetten.
Die Syntax der externen Ziele wird von der Markdown-Hilfe-Funktion dieses Moduls aufgelistet. In den meisten Fällen muss nur ein einzelnes Schlüssel-Wert-Parameterpaar angegeben werden, bestehend aus dem Kurznamen des gewünschten Ziels und der ID des dort befindlichen Datensatzes.
Beispiel
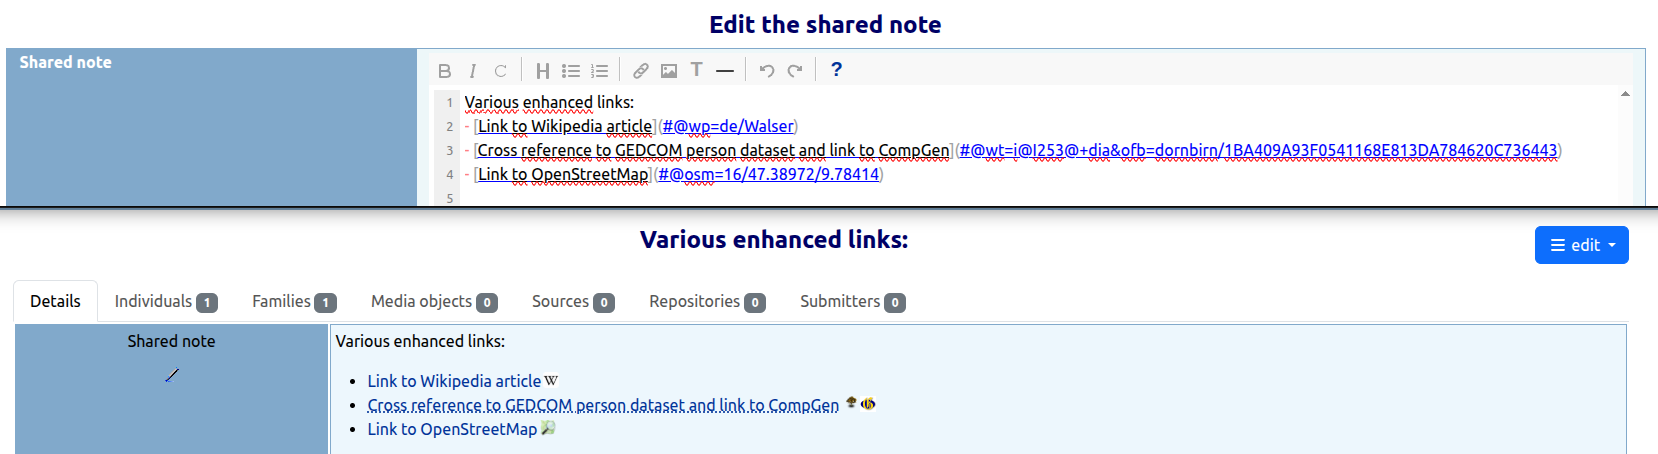
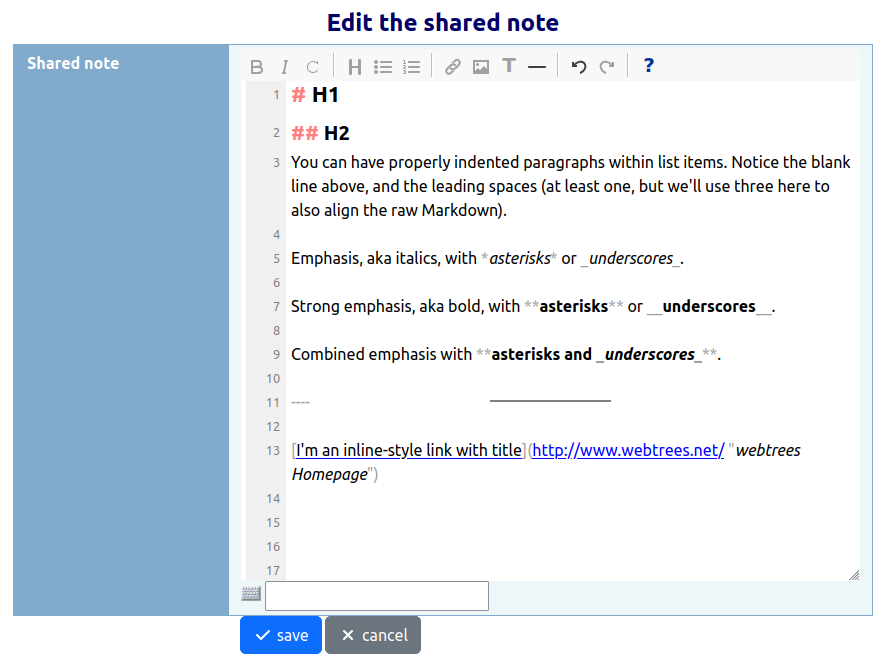
Im oberen Teil des Bildes ist der Bearbeitungsmodus eines Notizdatensatzes zu sehen, unten die Darstellung im Anzeigemodus:
2.2.1.1 - Querverweis-Übersicht
Querverweis-Übersicht mit Link-Index für große Bäume
Es gibt drei Arten von Übersichten:
Übersicht über alle Daten für den Admin (Admin-Übersicht),
auf einen Stammbaum begrenzte Übersicht (Benutzer-Übersicht) und
auf einen Datensatz bezogene Übersicht in der Detailansicht (Datensatz-Übersicht, als Tab oder Modal).
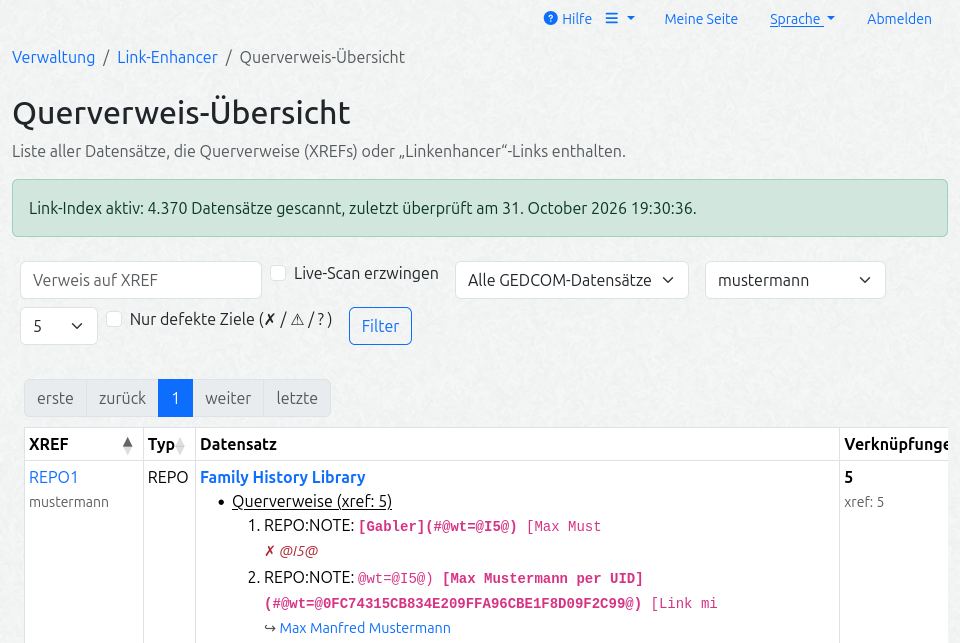
Die Admin-Übersicht (Verwaltung → LinkEnhancer → Querverweis-Übersicht) ist eine serverseitig paginierte DataTable. Sie listet alle Datensätze auf, die klassische @XREF@-Querverweise oder LinkEnhancer-Links enthalten, mit einer Link-Auflistung pro-Datensatz.
Optionale Filter:
referenzierte XREF (nur verfügbar, während ein frischer Link-Index aktiv ist — im Live-Scan-Modus ist das Feld ausgeblendet, da es dort nur ein grober Vorfilter wäre — keine klassischen Referenzen würden gefunden),
Datensatz-Typ,
Stammbaum und
die Anzahl der pro Link-Klasse angezeigten Token (alle / 5 / 10 / 20, Default 5).
Die XREF-Zelle zeigt den Stammbaumnamen als zweite Zeile in dezenter Schrift. Der Datensatz-Typ ist eine eigene sortierbare Spalte. Jedes Inventar-Token wird als kurzer Anzeigekontext (Snippet) mit dem Link-Token selbst in Fett angezeigt.
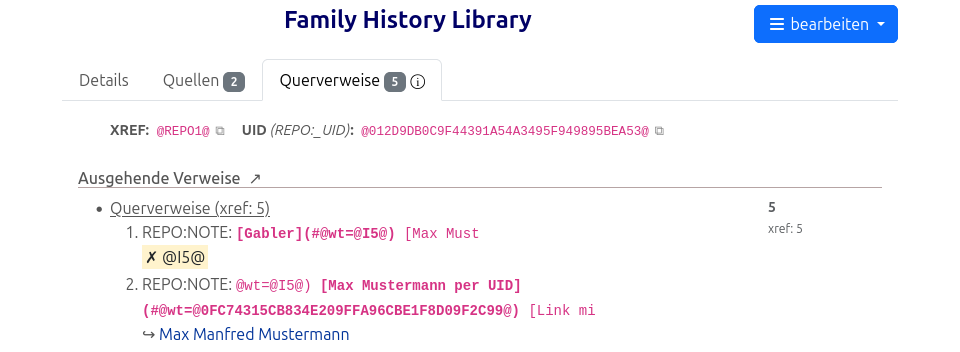
Optional kann man eine Benutzer-Übersicht pro Baum und eine Datensatz-Übersicht über die ein- und ausgehenden Referenzen pro GEDCOM-Datensatz aktivieren. Die Datensatz-Übersicht zeigt zudem die XREF und ggf. UIDs des Datensatzes an, damit diese Referenzen leichter in Notzen übernommen werden können.
Unterstützte Engines
Live-Übersicht
Link-Index (CLI)
MariaDB / MySQL
ja (REGEXP-Gate)
ja
PostgreSQL
ja (REGEXP-Gate)
ja
SQLite / SQL Server
Eingeschränkter Modus — automatischer Fallback auf ein grobes LIKE-Gate + Volltabellen-Scan pro Anfrage (Banner auf der Seite); die exakte Klassifizierung erfolgt weiterhin in PHP
nicht verfügbar (braucht REGEXP + MD5) — die CLI beendet sich mit einem Fehler
Funktionsweise
Bei großen Bäumen kann der Live-Regex-Scan über die GEDCOM-Tabellen langsam sein, daher kann die Seite stattdessen einen Link-Index aus drei Modultabellen lesen (der Abschnitt Entwicklung / Projekt-Struktur enthält mehr Details zum Datenbank-Schema):
le_record_scan — eine Zeile pro gescanntem Datensatz mit einem MD5-Fingerprint des Datensatztextes
le_link_index — eine Zeile pro (Link, Ziel), das im Datensatz gefunden wurde (der zum Build-Zeitpunkt erfasste Anzeigekontext) — das Fundament für Anzeige der eingehenden Querverweise in der Datensatz-Übersicht
le_index_meta — einzelne Zeile — der Zustand des letzten vollständigen Index-Laufs
flowchart TD
    CLI["🛠 cli/build-link-index.php<br/>Cron: */30 * * * *"]

    subgraph Scan["🔍 Inkrementeller Scan"]
        FP["MD5-Fingerabdruck<br/>pro Record"]
        DIFF{"🔀 Geändert?<br/>(neu / entfernt)"}
    end

    subgraph Tables["💾 Tabellen"]
        RS[("le_record_scan<br/>file, xref, hash")]
        LI[("le_link_index<br/>token, target, snippet")]
        META[("le_index_meta<br/>last_run, rows")]
    end

    PAGE["📄 XREF-Übersichtsseite"]

    CLI --> Scan
    FP --> DIFF
    DIFF -->|✅ ja| SCAN["PHP-Scan<br/>(XrefsService)"]
    DIFF -->|⏭ nein| SKIP["überspringen"]
    SCAN --> RS
    SCAN --> LI
    CLI --> META

    META -->|"🟢 fresh (< 2 h)"| PAGE
    META -->|"🟠 stale"| LIVE["Live-Regex-Scan"]
    LIVE --> PAGE

    classDef scanStyle fill:#e3f2fd,stroke:#1565C0,stroke-width:2px
    classDef tablesStyle fill:#e8f5e9,stroke:#2E7D32,stroke-width:2px
    classDef decideStyle fill:#fff3e0,stroke:#E65100,stroke-width:2px
    classDef pageStyle fill:#fce4ec,stroke:#C2185B,stroke-width:2px

    class FP scanStyle
    class RS,LI,META tablesStyle
    class DIFF decideStyle
    class PAGE pageStyle
Initialer Build (erster Lauf oder --rebuild): Beide Indextabellen werden zurückgesetzt, alle Scan-Zeilen werden serverseitig in einer Bulk-Statement pro GEDCOM-Tabelle erstellt (schnell, null Zeilentransfer), und nur die Datensätze, die den Link-Vorfilter passieren, werden in PHP gescannt. Der initiale Build ist eine Einmal-Kosten — verwenden Sie einen höheren --limit dafür. Wenn er durch --limit unterbrochen wird, konvergiert der nächste Lauf (der Build ist idempotent).
Inkrementelle Läufe (der normale Cron-Fall): Nur Datensätze, deren MD5-Fingerprint sich geändert hat — oder die hinzugefügt/entfernt wurden — werden neu gescannt (cursor chunked), sodass der Job auch auf großen Sites günstig bleibt.
Cron-Beispiel (alle 30 Minuten, max. 2000 Datensätze pro Lauf):
Nur ein vollständiger Lauf (ohne --tree), der nicht durch --limit gekürzt wird, markiert den Index als frisch (le_index_meta.last_run). Ein durch --limit gekürzter Lauf setzt dort fort, wo er aufgehört hat; ein --tree-Lauf aktualisiert nur diesen Baum.
Index leeren (Flush)
--flush leert die Indextabellen und beendet sich (kein Rebuild) — für Tests (die Seite auf Live-Scan zwingen) und Wartung (sauberer Neustart bei kaputtem Index):
php modules_v4/linkenhancer/cli/build-link-index.php --flush            # alle Bäume
php modules_v4/linkenhancer/cli/build-link-index.php --flush --tree=5   # nur Baum 5
Das Frische-Flag wird immer zurückgesetzt, sodass die Seite zuverlässig auf den Live-Scan zurückfällt. Der nächste vollständige Lauf ist wieder ein initialer Build (Voll-Scan-Kosten). --flush kombiniert mit --rebuild ist redundant — --rebuild setzt bereits zurück und baut neu.
Was zählt als Link
Die Übersicht und der Index verwenden einen gemeinsamen Vorfilter (einzelne Quelle: XrefsService::linkPrefilterPatterns()):
NOTE (Level >= 1) mit @XREF@oder](#@-Link, mit Inhalt auf derselben Zeile. Ein NOTE-Wert, der exactly eine Referenz ist (1 NOTE @N5@), ist ein GEDCOM-gemeinsamer Notiz-Pointer — eine strukturelle Referenz, kein Text-Link, und wird nicht aufgelistet.
CONC/CONT/TEXT/_TODO mit @XREF@ (nackt ist ein Link) oder ](#@-Link
ein LE-Link kann einen optionalen id=@XREF@-Parameter tragen (maximal einer, die Position unter den Parametern ist egal) — wie die wt=-Parameter wird er als Link-Ziel indexiert
der eigene Level-0-Text einer gemeinsamen Notiz (0 @N1@ NOTE …)
die Übereinstimmung ist zeilenbasiert (keine Cross-Line-Matches), auf denselben Zeilen, die der Collector liest
Die Seite zeigt an, welche Quelle sie verwendet:
Index aktiv (grüne Notiz): ein vollständiger, kompletter Index-Lauf ist vor weniger als 2 Stunden beendet (Default; XrefsService::INDEX_FRESH_SECONDS)
Live-Scan (blaue Notiz): kein frischer Index — die Seite fällt auf den Live-Scan zurück
Eingeschränkter Modus (gelbe Notiz, SQLite/SQL Server): siehe Enginetabelle oben
Verwenden Sie p1-measure.php
(read-only) auf Ihrer Instanz, um zu prüfen, wie kostspielig der Live-Scan für Ihre Daten ist und den Cron-Zeitplan zu kalibrieren.
2.2.1.2 - xref_IDs neu nummerieren (mit Verweisen)
XREFs umnummerieren mit automatischer Link-Reparatur
Die webtrees Standardfunktion für die Umnummerierung (Verwaltung → Stammbäume verwalten → [Stammbaum] → xref_IDs neu nummerieren) löst Stammbaumübergreifende XREF-Kollisionen auf, aktualisiert aber keine LinkEnhancer- oder klassischen Links. Dieses Modul bietet eine erweiterte Umnummerierungsfunktion, die alle betroffenen Links in einem Schritt repariert.
Zugriff: Verwaltung → LinkEnhancer → xref_IDs neu nummerieren (mit Verweisen)
Ablauf:
Den Stammbaum mit XREF-Kollisionen auswählen (doppelte XREFs mit anderen Bäumen).
Die Seite zeigt jede kollidierende XREF, ihren Record-Typ und die Anzahl der eingehenden LinkEnhancer-Referenzen aus dem Link-Index.
Beim Absenden wird jede kollidierende XREF:
in den GEDCOM-Core-Tabellen umbenannt (gleich wie die Standard-Umnummerierung)
alle wt=@XREF@ / id=@XREF@-Links in Notizen und Blöcken aktualisiert
der Link-Index (le_link_index) und UID-Index (le_uid_index) werden inline oder an Cron delegiert repariert
Jeder umnummerierte Datensatz wird im Edit-Log protokolliert (Admin → Änderungslog), z.B. Renumbered @I456@ → @I457@ (INDI, 3 core rows, 2 links).
Wenn die PHP-Ausführungszeitgrenze erreicht wird, stoppt der Lauf mit teilweisem Fortschritt — die verbleibenden Kollisionen werden im nächsten Lauf umnummeriert.
Hinweis: Die Standard-webtrees-Umnummerierung (ohne Links) bleibt verfügbar und ist nicht betroffen. Verwenden Sie die Umnummerierung dieses Moduls, wenn Ihre Notizen oder Blöcke LinkEnhancer-Links enthalten.
Siehe auch: fisharebest/webtrees#5156
2.2.1.3 - Datenkorrekturen
Datenkorrektur-Handler für Link-Integritätsprobleme
Das Modul bietet eine Reihe von Datenkorrektur-Handlern, die über die webtrees Datenkorrektur-Schnittstelle erreichbar sind (Steuerungspanel → Datenkorrekturen → LinkEnhancer). Jeder Handler adressiert ein spezifisches Link-Integritätsproblem:
Korrektur
Was sie tut
XREF ⇄ UID Referenz-Tausch
Konvertiert LinkEnhancer-Link-Ziele zwischen XREF- und UID-Form. Richtung ist wählbar (XREF→UID oder UID→XREF). Erfordert, dass der UID-Index aufgebaut ist.
wt= Typ-Buchstabe korrigieren
Setzt, repariert oder entfernt den Legacy-Typ-Buchstaben in wt=<type>@REF@-Links. Modi: setzen (fehlenden Typ hinzufügen), reparieren (falschen Typ korrigieren), entfernen (Typ-Buchstaben streichen).
Verwaiste Link-Ziele melden
Nur Bericht: Listet LinkEnhancer-Links auf, deren Ziel-Datensatz nicht mehr existiert. Es werden keine Änderungen vorgenommen.
Mehrdeutige UID-Ziele melden
Nur Bericht: Listet Links auf, deren UID-Ziel auf mehr als einen Datensatz auflöst. Es werden keine Änderungen vorgenommen.
Doppelte UIDs im Index melden
Nur Bericht: Listet UIDs auf, die im UID-Index mehreren Datensätzen zugewiesen sind. Es werden keine Änderungen vorgenommen.
Jede Korrektur folgt dem webtrees Datenkorrektur-Workflow: Korrekturtyp wählen → Vorschau → anwenden. Die Datenkorrektur-Seite zeigt auch den aktuellen Status der Link- und UID-Indizes und ob Index-Aktualisierungen an den Cron-Job delegiert werden.
2.2.2 - Markdown
Markdown-Rendering in Notizdatensätzen
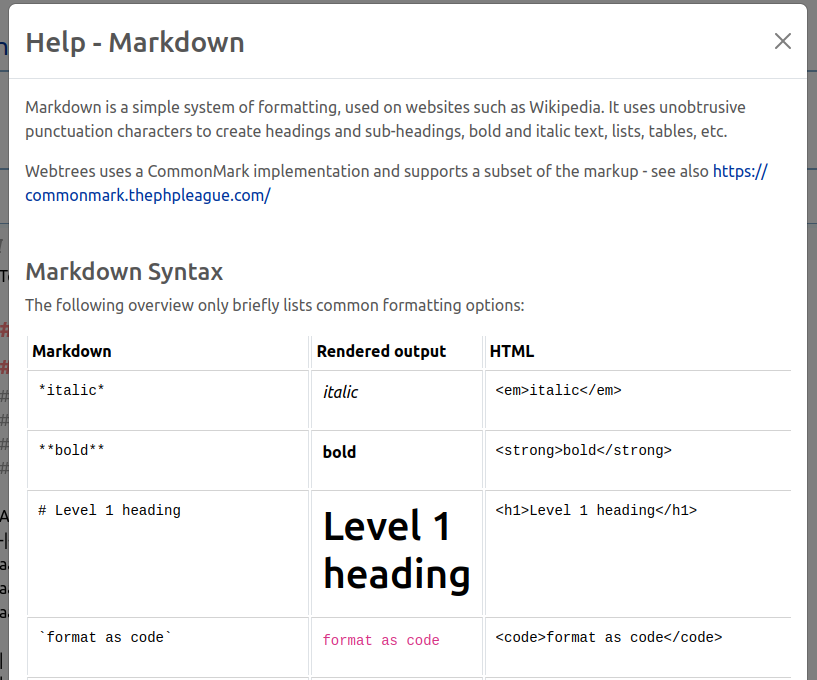
Markdown ist ein einfaches Formatierungssystem, das auf Websites wie Wikipedia oder GitHub verwendet wird. Es nutzt unauffällige Satzzeichen, um Überschriften, fett/kursiv Text, Listen, Tabellen usw. zu erstellen.
Webtrees verwendet eine CommonMark-Implementierung und unterstützt eine Untermenge des Markup. Es ist optional in Notizdatensätzen auf Baum-Ebene verfügbar.
Hinweis: Für die Markdown-Bild-Unterstützung und die zusätzlichen Markdown-Erweiterungen muss die MarkdownFactory-Klasse durch dieses Modul erweitert werden. Diese Ersatzklasse behebt auch fisharebest/webtrees#4841, sodass ein vorformatierter Markdown-Block nicht mehr als eine einzige Zeile gerendert wird.
2.2.2.1 - Markdown-Bild-Unterstützung
Bilder aus GEDCOM-Mediendatensätzen oder öffentlichen Ordner in Notizen einbetten
Diese Funktion erlaubt es, Bilder aus GEDCOM-Mediendatensätzen (die hinter der Media-Firewall liegen) oder aus dem öffentlichen Verzeichnis in Notizen einzubetten. Wenn Restriktionsregeln auf den Datensatz zutreffen, wird statt des Bildes eine Meldung angezeigt.
Syntax:


Technisch werden die Bilder in einen div-Container zusammen mit einem Bild-Untertitel gepackt — der auch ein Link zum Mediendatensatz ist. Die Darstellung kann wie gewünscht mit den Standard-CSS-Klassen oder zusätzlichen per-Bild-CSS-Klassen angepasst werden (z.B. float-start oder float-end aus webtrees vendor.css).
2.2.2.2 - Markdown-Editor
Visueller Markdown-Editor (TinyMDE) für Notizfelder
Neben der Syntax-Hervorhebung wird eine Icon-Leiste für gängige Formatierungsbefehle, ein Hilfe-Popup und Zeilennummerierung mitgeliefert.
Hinweis: Die On-Screen-Tastatur funktioniert leider nicht mehr wie zuvor mit dem vorherigen Texteingabefeld. Die gewählten Zeichen landen als Zwischenschritt im kleinen Textfeld unter dem Markdown-Editor und müssen manuell an die gewünschte Position kopiert werden.
Warnung: Bitte bedenken Sie bei der Verwendung dieser Erweiterungen, dass Sie vom kleinsten gemeinsamen Markdown-Dialekt abweichen. Wenn die Bibliothek, die Markdown in HTML rendert, aus irgendeinem Grund geändert werden muss, ist es möglich, dass nicht alle hier verwendeten erweiterten Markup unterstützt werden (siehe auch #32). Da das Markup nicht aufdringlich ist, sollte der Impact nicht gravierend sein — natürlich ist es ein kleiner Nachteil.
Das Paket League\CommonMarkdown, das zur Verarbeitung von Markdown-Texten verwendet wird, bietet mehrere nützliche Erweiterungen, die optional aktiviert werden können:
Man kann alle oder einige ausgewählte dieser Erweiterungen aktivieren. Soweit möglich sind sie natürlich mit dem Markdown-Editor integriert und man findet zusätzliche Informationen in der Markdown-Hilfe.
Fußnoten
Fußnoten können in der Nähe ihrer Verweise platziert werden (es kann ein oder mehrere Verweise auf eine Fußnote geben) oder überall dort, wo man möchte. Für den Überblick ist es ratsam, sie unten anzubringen. Beim Rendering befindet sich der Fußnoten-Container am Ende des Inhalts.
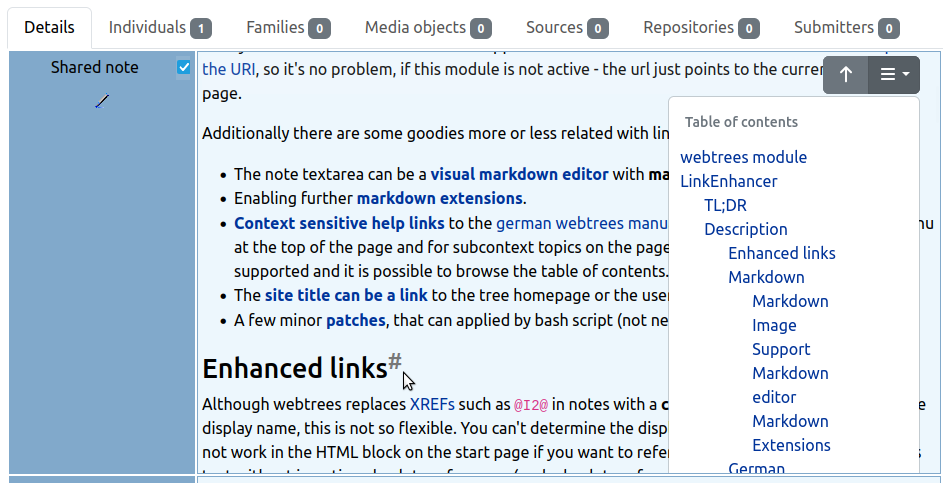
Inhaltsverzeichnis
Wenn der Text mit Überschriften strukturiert ist, ist es eine gute Wahl, die Inhaltsverzeichnis-Erweiterung zu aktivieren. Das Inhaltsverzeichnis wird automatisch generiert und in den Inhalt über der allerersten Überschrift oder anstelle eines Platzhalters eingefügt.
2.2.2.4 - Tabellen-Zellenhöhe steuern
Für längere Markdown-Notiztexte ist es manchmal mühsam, scrollen zu müssen, wenn man sich für die Fakten darunter interessiert. Diese Funktion sollte hier weiterhelfen: Durch Aktivieren des Häkchens in der oberen rechten Ecke der Titelspalte (erste Tabellenspalte) wird die maximale Höhe der Inhaltszelle mit der langen Notiz auf ca. 80% der Viewport-Höhe gesetzt. Damit wird der Inhalt selbst scrollbar.
Wo anwendbar, kann die Funktion standardmäßig aktiviert (oder einfach verfügbar gemacht) und auch unabhängig deaktiviert werden.
In Kombination mit der Inhaltsverzeichnis-Erweiterung (Position = Dropdown) kann man den Text leicht durchnavigieren — vorausgesetzt, der Text ist mit Überschriften strukturiert.
Man kann entscheiden, ob das Häkchen immer sichtbar ist oder erst beim Überfahren der Fakt-Titelspalte mit dem Mauscursor. Wenn die Textlänge der Inhaltszelle die definierte Maximalhöhe nicht überschreitet, kann das Häkchen nicht aktiviert werden.
2.2.3 - Deutsches webtrees Handbuch (WTHB)
Kontextsensitive Hilfe-Links zum deutschen webtrees Handbuch
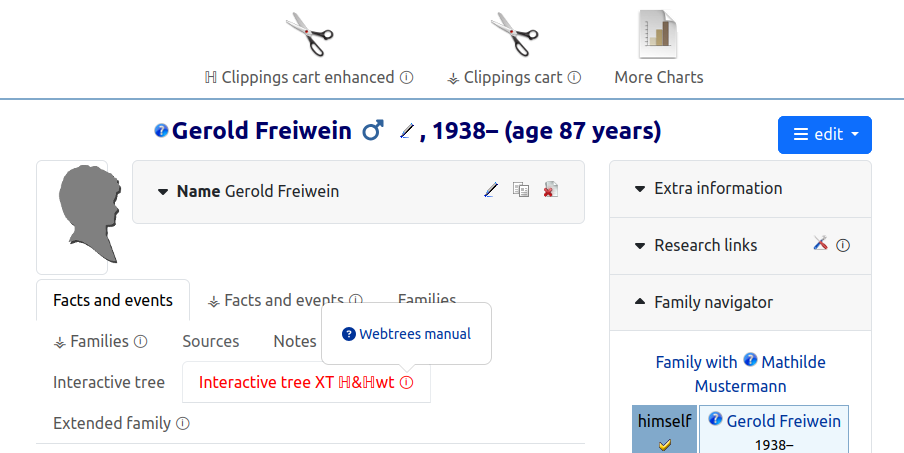
Ein kontextsensitiver Hilfe-Link zum deutschen webtrees Handbuch kann dem kleinen Navigationsmenü hinzugefügt werden. Kontext-Links sind auch für Komponenten auf Seiten von Custom-Modulen verfügbar (z.B. auf der Personenseite, der Startseite oder bei Elementen im Hauptmenü) — diese sind an den i-Symbolen in einem Kreis erkennbar.
Zur Sicherstellung, dass diese Funktion auch im Admin-Bereich verfügbar ist, muss eine modifizierte Version von views/layouts/administration.phtml registriert werden. Dieses Modul versucht, das Custom-Modul vesta_common zu verwenden (falls installiert und aktiviert) oder seine eigene Version der View-Layout-Datei. Alternativ kann auch Patch P002 auf den Core-Code angewendet werden.
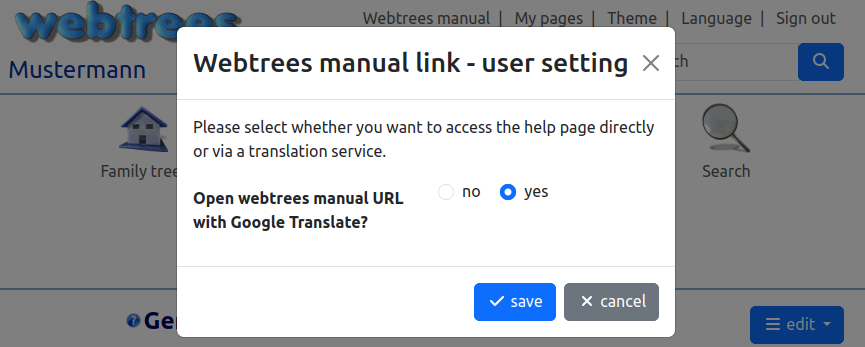
Wenn die webtrees-Seite in einer anderen Sprache als Deutsch angezeigt wird, ist es möglich, die webtrees-Handbuch-URL über einen Übersetzungsdienst zu öffnen (Google Translate). Dies kann als Site-Einstellung aktiviert/deaktiviert oder dem Besucher überlassen werden.
Hinweis: Aufgrund von AI-Bot-Einschränkungen auf dem GenWiki ist diese Funktion derzeit nutzlos.
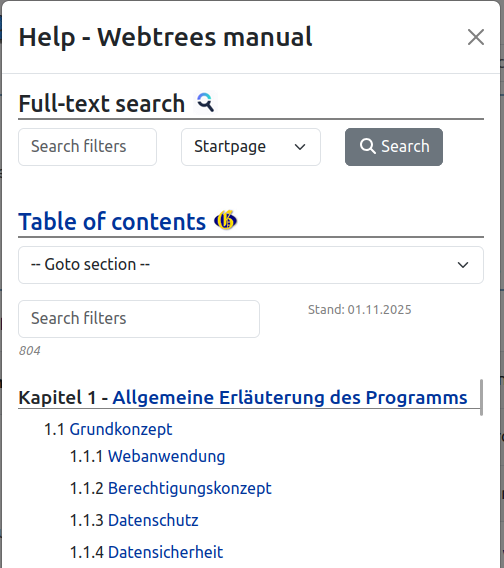
Der Einstellungsdialog kann über das Hilfe-Untermenü im oberen Menü aufgerufen werden. Wenn diese Option aktiviert ist, findet man auch einen Link zu einem Dialogfeld, das eine Volltextsuche im deutschen webtrees Handbuch (mit verschiedenen Suchmaschinen) und das Inhaltsverzeichnis anzeigt. Wie das TOC selbst erzeugt wird (GenWiki-Rundlauf, Generierung, Weblate) steht auf der Seite WTHB-TOC-Language-Pipeline.
Untermenü
Zusätzlich enthält das Untermenü eine Übersicht der im Handbuch enthaltenen Hilfe-Themen und anpassbare externe Hilfe-Links (z.B. webtrees FAQ und Forum, GitHub-Repo, etc.). Der obere Menüeintrag kann in zwei Links aufgeteilt werden — einer zum direkten Öffnen des Kontext-Hilfe-Artikels und der andere zum Öffnen des Untermenüs.
2.2.4 - Home-Link
Seitentitel als konfigurierbarer Link mit themenbewusstem CSS
Der Seitentitel kann ein Link zur Baum-Startseite oder zur Benutzer-Mein-Seite sein. Der Webmaster kann auch eine benutzerdefinierte URL setzen.
Dynamische CSS-Stile können angewendet werden, um dem aktuellen Theme zu entsprechen und sicherzustellen, dass die Anzeige gut kontrastiert. Natürlich ist es nicht auf den Home-Link-Fall beschränkt - Details siehe Admin-Einstellungen.
2.2.5 - UID-Suche
Navigation zu einem Datensatz über seine persistente UID
Eine UID (_UID in GEDCOM 5.5.1, UID in GEDCOM 7.0) ist eine persistente Kennung, die einem Datensatz zugewiesen wird. Die UID übersteht XREF-Umnummerierungen und Baum-Migrationen und ist damit ein stabiler Referenzpunkt.
Diese Funktion ermöglicht die direkte Navigation zu einem Datensatz über seine UID. Das URL-Muster ist:
/tree/{baum}/goto-uid/{uid} — auf einen Baum beschränkt
/goto-uid/{uid} — global (durchsucht alle Bäume)
Verhalten:
0 Treffer → 404
1 sichtbarer Treffer → Weiterleitung zum Datensatz
>1 sichtbarer Treffer → Auswahl-Liste (UIDs mit unterschiedlicher Groß/Klein-Schreibung oder dieselbe UID in mehreren Datensätzen)
Der UID-Vergleich ist case-insensitive (GEDCOM-Spezifikationen definieren UID nicht als case-sensitive). Der gespeicherte Wert ist wörtlich; die Übereinstimmung wird case-insensitiv geprüft, sodass UIDs mit unterschiedlicher Groß/Klein-Schreibung eine Auswahl-Liste zurückliefern statt einer möglicherweise falschen einzelnen Weiterleitung.
UIDs können über die Schnellsuche gesucht werden. Für kürzere UIDs, die als XREF durchgehen könnten, kann das Präfix uid: vorangestellt werden.
Standard-Navigation (goto-id)
goto-id ist das Standard-Navigationsziel für jeden LinkEnhancer-Link — sowohl untypisiert (wt=@REF@) als auch typisiert (wt=<type>@REF@) — und löst eine Referenz auf, die entweder ein XREF oder eine UID ist. Das URL-Muster ist:
/tree/{baum}/goto-id/{id} — auf einen Baum beschränkt (fällt auf globale Suche zurück, wenn im Baum nichts gefunden wird, mit Flash-Benachrichtigung)
/goto-id/{id} — global (durchsucht alle Bäume)
Verhalten (gemeinsamer IdResolver): Die ID wird längenbasiert und bidirektional versucht — eine lange ID (≥ 18 Zeichen) zuerst als UID, eine kurze zuerst als XREF — und fällt auf die andere zurück, wenn die erste nichts ergibt, sodass eine Auflösung nie verloren geht. 0 Treffer → 404, 1 sichtbarer Treffer → Weiterleitung, >1 → Auswahl-Liste.
sequenceDiagram
    autonumber
    participant U as 👤 Nutzer (Browser)
    participant JS as LE JavaScript
    participant WT as webtrees-Server
    participant IR as IdResolver
    participant DB as Datenbank

    Note over U,JS: Klick auf einen LE-Link
    U->>JS: Klick auf #@wt=@I234@
    JS->>JS: detect href "#@…"
    JS->>WT: GET /tree/5/goto-id/I234
    WT->>IR: resolve("I234", tree=5)

    alt ID short (< 18 chars) → try as XREF first
        IR->>DB: SELECT … WHERE xref = 'I234'
        DB-->>IR: Treffer?
    else ID long (>= 18 chars) → try as UID first
        IR->>DB: SELECT … FROM le_uid_index WHERE uid = '…'
        DB-->>IR: Treffer?
    end

    alt ✅ 1 Treffer
        IR-->>WT: Record
        WT-->>U: Weiterleitung zur Record-Seite
    else 0 Treffer → Fallback
        IR->>IR: andere Richtung versuchen (XREF ⇄ UID)
    else >1 matches
        WT-->>U: Auswahl-Liste
    end

    Note over IR,DB: Bidirektional — XREF ⇄ UID<br/>eine Auflösung geht nie verloren
Ein typisierter wt=<type>@REF@-Link ist eine Legacy-Form: der Typ-Buchstabe wird nicht mehr für das Routing verwendet (alle Links gehen über goto-id) und ist nur dokumentarisch — er steuert weiterhin den Diagramm-Link für Personen und den Typ-Mismatch-Hinweis in der Querverweis-Übersicht. Neue Links sollten die untypisierte wt=@REF@-Form verwenden.
XREF-Route (goto-xref)
Es ist auch die Route /tree/{baum}/goto-xref/{xref} verfügbar, die es erlaubt, unabhängig vom Record-Typ zum entsprechenden Datensatz im Baum zu navigieren.
Querverweis-Übersicht: UID-Ziele in anderen Bäumen
In der Admin-Querverweis-Übersicht wird ein Link, dessen UID-Ziel nicht im eigenen Baum des Datensatzes gefunden wird, normalerweise als “Ziel nicht gefunden” angezeigt. Wenn die UID-Funktion aktiviert ist, wird ein solches Ziel zusätzlich global (über die anderen Bäume hinweg) aufgelöst; wenn Treffer existieren, wird es als nicht eindeutig (?) mit der Trefferanzahl angezeigt: bis zu 3 Treffer werden als direkte Cross-Tree-Links aufgelistet, mehr als 3 kollabieren zu einem einzelnen goto-id-Link (Titel = die UID). Dieses Verhalten ist hart an der UID-Funktions-Einstellung gated und gilt nie für Ziele, die einen expliziten Baum benennen.
Index
Der UID-Index wird in der Tabelle le_uid_index gespeichert (eine Zeile pro UID-Tag-Vorkommen, unterschieden durch tag_path). Er wird ausschließlich durch build-uid-index.php
gepflegt (kein Live-Scan bei Anfragen).
Initialer Build (erster Lauf oder --rebuild): Vollständiger Scan aller GEDCOM-Tabellen, Extraktion aller UID-Tags via UidTagCollector.
Inkrementelle Läufe: Nur Datensätze, deren MD5-Fingerprint sich geändert hat (oder hinzugefügt/entfernt wurden), werden neu gescannt.
Cron-Beispiel (alle 10 Minuten, max. 5000 Datensätze pro Lauf):
Die Funktion kann auf der Modul-Admin-Seite ein-/ausgeschaltet werden (“Aktivieren” → [5] UID-Suche). Der aktuelle Index-Status (Zeilenanzahl, letzter Build-Zeitpunkt) wird dort angezeigt.
Während die Funktion ausgeschaltet ist, werden Index-Builds automatisch übersprungen (der Cron-Lauf beendet sich mit Exit 0 ohne Arbeit). --force baut den Index trotzdem (z.B. zur Vorbereitung der Reaktivierung), und --flush funktioniert unabhängig vom Schalter.
Hinweis: UID-Tags auf jeder Verschachtelungsebene werden indexiert (z.B. 0 @I1@ INDI, 1 _UID, 1 FAMF, 2 _UID). Der Tag-Pfad wird pro Zeile gespeichert, sodass Duplikate in der Auswahl-Liste unterscheidbar sind.
2.2.6 - Patches
Optionale webtrees Core-Patches
Die Patches können zusätzlich angewendet werden — das Modul funktioniert auch ohne sie!
Der util-Unterordner enthält kleine Patches für den webtrees-Core. Dies sind Diff-Dateien, die per Shell aus dem installierten Modulordner heraus leicht angewendet oder entfernt werden können (notwendig für die Auto-Erkennung der webtrees-Quellen):
Usage: util/wt-patch.sh [-R][FILTER] -R Patch rückgängig machen (patch -R) FILTER '*' für alle oder spezifisch (z.B. '01')
Vergessen Sie nicht, die Patches nach einem webtrees-Update neu anzuwenden.
Es handelt sich um kleine Bugfixes oder Funktionserweiterungen — meist in einer einzelnen Datei — die dazu dienen, die Lücke bis zu einer offiziellen Behebung/Implementierung im webtrees-Core zu überbrücken.
#
Beschreibung
Gilt für Version
P001
Backlink für Level-1-gemeinsame Notizen #5181 — nicht mehr notwendig, es sei denn, man möchte einen zusätzlichen Edit-Link. app/Fact.php
2.2.1 - 2.2.6
P002
headContent/bodyContent für dieses Modul im Admin-Bereich aktivieren, um den Kontext-Hilfe-Link anzuzeigen #5214. resources/views/layouts/administration.phtml
2.2.1 - 2.2.6
P003
Datensatz hat mehrere uid-Felder #4828. app/Services/GedcomEditService.php
2.2.1
2.3 - Entwicklung
Entwicklungs-Dokumentation
2.3.1 - CLI-Skripte
Command-Line-Wartungsskripte
Das Modul bringt ausschließlich CLI-Skripte mit. Sie sind geschützt: bei Aufruf über HTTP (das Verzeichnis modules_v4 liegt innerhalb des Web-Roots) antworten sie mit 403 anstatt auszuführen.
Wenn Sie zu diesem Modul beitragen möchten, großartig! Sie können beitragen, indem Sie:
Code beisteuern — schauen Sie sich die Issues für Dinge an, die Aufmerksamkeit brauchen. Wenn Sie Änderungen vornehmen möchten, die nicht in einem Issue aufgeführt sind, erstellen Sie bitte eines, damit Sie Ihren Pull Request verlinken können.
Testen — derzeit ist alles manuell; bitte erstellen Sie ein Issue für jeden Bug, den Sie finden.
Übersetzung
Sie können zu diesem Projekt auf Codeberg Weblate beitragen. Aktualisierte Übersetzungen werden in der nächsten Version dieses Moduls enthalten sein.
Das Modul besitzt fünf Tabellen (Präfix le_), die inkrementell durch src/Schema/Migration#.php erstellt werden. Jede Migration ist additiv und idempotent, sodass das Schema bei jedem Modul-Load konvergiert.
le_route_help_map
Ordnet eine webtrees-Route (path / handler / method) einem Hilfe-Eintrag zu — der Speicher für die kontextsensitive Handbuch-Hilfe. Wird von SeedHelpTable befüllt.
Spalte
Typ
Hinweise
id
int, PK (auto)
path
varchar(255)
Routen-Pfad
handler
varchar(150)
vollqualifizierte Handler-Klasse
handler_key
varchar(150), index
versionsneutrale Key (2.2.6 + 2.3 kompatibel)
method
varchar(20)
extras
varchar(60)
subcontext
varchar(250)
category
varchar(60)
standard / custom module / generic …
order
int, Default 10
url
varchar(250)
updated_at
timestamp, nullable
Index auf (path, handler) und auf handler_key.
le_record_scan
Eine Zeile pro gescanntem GEDCOM-Datensatz, mit einem MD5-Fingerprint des Datensatztextes — lässt dem CLI-Index eine inkrementelle Diff-Prüfung zu.
Spalte
Typ
Hinweise
file
int
Baum-ID (Teil des PK)
xref
varchar(20)
(Teil des PK)
rectype
varchar(15)
GEDCOM-Tag, z.B. INDI, OBJE (Teil des PK)
hash
varchar(32)
MD5 des Datensatztextes
scanned_at
timestamp, nullable
Primärschlüssel (file, xref, rectype).
le_link_index
Eine Zeile pro (Link, Ziel) in einem Datensatz — das Fundament für die geplante Backlink-Funktion.
Spalte
Typ
Hinweise
id
int, PK (auto)
file
int
Baum-ID
xref
varchar(20)
rectype
varchar(15)
tag_path
varchar(255)
wo der Link im Datensatz sitzt
link_class
varchar(10)
xref / ext / pic / classic / other
token
text
das rohe Link-Token
snippet
text, nullable
zum Build-Zeitpunkt erfasster Anzeigekontext
target_xref
varchar(20), nullable
XREF-Link-Ziel
target_tree
varchar(255), nullable
target_uid
varchar(255), nullable, index
UID-Link-Ziel (per Längen-Heuristik befüllt)
Indizes auf (file, xref, rectype), target_xref und target_uid.
le_uid_index
Eine Zeile pro in einem Datensatz gefundenem UID-Tag (Datensatz- und Fakt-Ebene). Kein Unique-Constraint — UIDs sind nicht eindeutig garantiert.
Spalte
Typ
Hinweise
id
int, PK (auto)
file
int
Baum-ID
xref
varchar(20)
uid
varchar(255), index
UID-Wert wörtlich (ohne Normalisierung)
rectype
varchar(15)
tag_path
varchar(255)
hash
varchar(32)
MD5-Fingerprint (inkrementelle Änderungsprüfung)
Indizes auf uid und (file, xref, rectype).
le_index_meta
Eine einzelne Zeile (id = 1) mit dem Frische-Zustand von beiden — dem Link-Index und dem UID-Index.
Spalte
Typ
Hinweise
id
int, PK, Default 1
einzelne Zeile
last_run
timestamp, nullable
letzter vollständiger Link-Index-Lauf
rows
int, Default 0
Zeilenzahl des Link-Index
uid_last_run
timestamp, nullable
letzter vollständiger UID-Index-Lauf
uid_rows
int, Default 0
Zeilenzahl des UID-Index
2.3.4 - Klassenhierarchie
Automatisch generierter Klassenüberblick
Automatisch generiert durch docs/tools/generate-class-hierarchy.php — nicht manuell bearbeiten.
Schwester-Repo unter modules_v4/wt-shared-libs (Composer-Path-Repo)
Lage
Das Modul liegt innerhalb einer webtrees-Installation unter modules_v4/linkenhancer/. Sein composer.json
zieht die Schwester-Bibliothek als lokales Path-Repository ein:
Hinweis:composer.json
setzt prepend-autoloader: false — der Autoloader des Moduls wird an den Autoloader von webtrees angehängt (nicht ersetzt).
Bind-Mount
Im aktuellen Setup wird auf Linux mit nativ installiertem Apache Webserver entwickelt. Der Quellbaum der PHP-Laufzeit wird über einen Bind-Mount der Repo-Ordner unterhalb von modules_v4 bereitgestellt. Die CLI-Tools und PHPStan müssen vom Mount-Pfad aus ausgeführt werden (den Pfad, den die webtrees-Instanz sieht), nicht vom Quellpfad, damit app/ und vendor/autoload.php richtig auflösen:
cd /path/to/webtrees/modules_v4/linkenhancer
composer analyse
Gulp-Tasks für JS/CSS-Bundling, Übersetzungen und Versionierung
Bundling, Übersetzungs-Kompilierung und Versionierung werden über Gulp-Tasks in gulpfile.mjs
gesteuert, aufgerufen mit npx gulp <task>. Die npm run *-Skripte decken nur das Testing ab — siehe die Seite Testing.
ergänzt Issue-Referenzen in Commit-Messages (braucht FORGEJO_TOKEN in .env) - wurde nur einmalig angewendet für die Übernahme des Repos von GitHub zu Codeberg
JS / CSS Bundling
build = clean → (parallel) JS + CSS.
clean löscht zunächst resources/js/bundle* und resources/css/bundle*.
JS (Rollup): zwei Entry-Bundles — jsIndex (das Haupt-index-le.js
) und jsExtractLeConfig (le-config.js
). Ausgabe nach resources/js/bundle*.
CSS (PostCSS): Dateibasierte Subtasks aus getCssSubTasks(), mit autoprefixer + cssnano. Ausgabe nach resources/css/bundle*.
Dev-Mode (devbuild) schaltet per toggleDevMode(true) einen Flag um — er deaktiviert das Minifizieren und erzeugt SourceMaps.
Build- & Archive-Pipeline
flowchart LR
    subgraph B["🔧 npx gulp build"]
        C["🧹 clean<br/>(bundle*)"]
        J["`📜 Rollup<br/>**index-le.js** · le-config.js`"]
        P["🎨 PostCSS<br/>autoprefixer · cssnano"]
        C --> J
        C --> P
    end
    subgraph A["📦 npx gulp archive"]
        A1["build"]
        A2["po2php"]
        A3["`create-archive.sh<br/>**dist/linkenhancer_v<ver>.zip**`"]
        A1 --> A2 --> A3
    end

    classDef bStyle fill:#e3f2fd,stroke:#1565C0,stroke-width:2px
    classDef aStyle fill:#e8f5e9,stroke:#2E7D32,stroke-width:2px

    class C,J,P bStyle
    class A1,A2,A3 aStyle
Übersetzungsdateien
updatepo regeneriert nur die Vorlage (messages.pot). Die .po-Dateien selbst werden über Weblate aktualisiert, nicht lokal, um Konflikte zu vermeiden — siehe die Seite Übersetzungs-Pipeline.
po2php wandelt die committeten .po-Dateien in die PHP-Arrays um, die webtrees zur Laufzeit lädt.
2.3.7 - Übersetzungs-Pipeline
Wie übersetzbare Strings vom Quellcode bis zur Laufzeit fließen (xgettext → Weblate → PO → PHP)
Das Modul bringt seine eigenen Übersetzungen über die Standard-gettext-Kette ein, gehostet auf Codeberg Weblate.
Ablauf
flowchart TB
    subgraph Extraction["1️⃣ Quellcode → POT"]
        direction LR
        PHP["📝 src/*.php"] -->|npx gulp updatepo| POT["📄 messages.pot"]
    end

    subgraph Translation["2️⃣ Übersetzung"]
        direction LR
        WEBLATE["🌐 Weblate"] -->|download| PO["🗝 <lang>.po"]
    end

    subgraph Rendering["3️⃣ Webtrees"]
        direction LR
        PHPARR["📦 lang.php"] -->|I18N| RENDER["✅ Rendering"]
    end

    POT -->|upload| Translation
    PO -->|npx gulp po2php| Rendering

    classDef sourceStyle fill:#e3f2fd,stroke:#1565C0,stroke-width:2px
    classDef fileStyle fill:#e8f5e9,stroke:#2E7D32,stroke-width:2px
    classDef weblateStyle fill:#f3e5f5,stroke:#7B1FA2,stroke-width:2px
    classDef renderStyle fill:#fce4ec,stroke:#C2185B,stroke-width:2px

    class PHP sourceStyle
    class POT,PO,PHPARR fileStyle
    class WEBLATE weblateStyle
    class RENDER renderStyle
Strings extrahieren
update-po-files.sh
führt xgettext über jede *.php / *.phtml aus, außer util/, vendor/, node_modules/ und tests/:
I18N::translate() / MoreI18N::translate() — modulspezifische Strings. translate ist ein xgettext-Keyword, daher werden diese aufgenommen.
MoreI18N::xlate() — Strings, die bereits vom webtrees-Core-POT abgedeckt sind. Gleiches Laufzeit-Verhalten, anderer Name, daher unsichtbar für xgettext. Nach einem Core-Update messages.pot mit dem Core-POT vergleichen und neu abgedeckte msgids auf xlate() umstellen.
.po-Dateien werden nicht lokal gemergt — das ist Weblates Aufgabe, um Konflikte zu vermeiden. Sobald Weblate aktualisierte .po-Dateien liefert, kompilieren:
npx gulp po2php
Hinweis: ein früherer .po → .mo-Schritt ist überflüssig (Formatwechsel bei den Übersetzungen, Issue #88).
2.3.8 - WTHB-TOC-Language-Pipeline
Wie das Inhaltsverzeichnis des deutschen webtrees-Handbuchs erzeugt wird (GenWiki → pywikibot → Generierung → externes Repo / Pages / Weblate → Modul)
Überblick
Das Paket linkenhancer-wthb-toc-lang stellt das Inhaltsverzeichnis (TOC) des deutschen webtrees-Handbuchs — samt Übersetzungen — der WTHB-Hilfefunktion zur Verfügung. Die Produktion ist ein Rundlauf, der komplett außerhalb der webtrees-Installation läuft: Er liest das Handbuch von GenWiki, erzeugt das TOC neu, schreibt das Ergebnis als MediaWiki-Template zurück nach GenWiki und — parallel — die strukturierten Daten in ein externes Codeberg-Repo, das Codeberg Pages, Weblate (Übersetzungen) und schließlich das Modul versorgt. Diese Seite dokumentiert die Produktionsseite; die Konsumenten-Seite (Cache, CLI, Rendering) steht auf der WTHB-Funktionsseite und der Seite CLI-Skripte.
Der Rundlauf hat zwei Hälften: den GenWiki-Rundlauf (Handbuch lesen → generieren → TOC-Template zurück schreiben) und die Delivery-Pipeline (strukturierte Daten → externes Repo → Pages / Weblate → Modul).
Template zurück nach GenWiki schreiben (pywikibot WRITE)
gerendertes Template per Parse-Check prüfen (curl + jq)
JSON in das externe Repo deployen
nachgelagert: Repo-CI, Weblate und Modul holen die Daten
GenWiki-Datenabfrage (pywikibot READ)
Schritt 1 ist wt-maintain.py, ein pywikibot-Bot (SectionsExportBot, erbt von ExistingPageBot). Er ruft site.login() auf, iteriert allpages(prefix="Webtrees Handbuch") und fragt pro Seite die MediaWiki-API (action=parse&prop=sections) plus imagelinks() (FilePage-Info) ab. Ergebnis sind drei CSV-Dateien:
wthb-pageinfo.csv,
wthb-sections.csv und
wthb-images.csv.
Zwei manuelle Nacharbeiten bleiben (laut Skript-Header): (b) das Bilderverzeichnis pflegen und (c) die Bilder in die Kategorie:Webtrees legen — von Hand (Helfer: wt-webtrees-cat-files.sh).
TOC-Generierung — wt-gen-toc.py
Schritt 2 ist ein pandas-Skript, das den IST-Zustand (die drei CSVs) mit der SOLL-Zielstruktur in wthb-pageinfo_ext.csv kombiniert. classify_prefix() vergibt Kapitel-/Abschnitts-Präfixe. Es schreibt vier Outputs:
wthb-toc.wiki — die MediaWiki-TOC-Quelle
wthb-toc.json — die strukturierten Daten, die das Modul verbraucht
de.json — die deutsche Sprachdatei für Weblate
wthb-toc.html — eine gerenderte HTML-Kopie (legacy/parallel — der aktuelle Konsument rendert aus JSON)
GenWiki-Template (pywikibot WRITE)
Schritte 3–4 wickeln das generierte TOC im MediaWiki-Template Vorlage:WT-Verzeichnis-TOC ein und schreiben es zurück:
die pagefromfile-Datei kombiniert einen <noinclude>-Teil ({{Dokumentation}} + [[Kategorie:Webtrees]]) mit einem <includeonly>-Teil (Stand: <datum> + <div class="wthbtoc">…</div>).
pywikibot pagefromfile -force -pt:1 -summary:"Bot: Webtrees Handbuch Inhaltsverzeichnis aktualisiert" führt den Write aus.
Schritt 5 verifiziert das Ergebnis, indem es das Template über die GenWiki-API (action=parse&format=json) neu parst und das HTML mit jq -r '.parse.text["*"]' extrahiert.
Externes Repo, CI & Pages
Die zweite Hälfte der Pipeline (ab Schritt 6) befördert die strukturierten Daten aus dem Host heraus:
flowchart TB
    OUT["`📦 *Ausgaben*<br/>wthb-toc.json + de.json`"]
    DEP["`🚀 **wt-deploy-toc-lang.sh**`"]

    subgraph EXTERNAL["🌐 Externe Infrastruktur"]
        REPO["`📦 **linkenhancer-wthb-toc-lang**<br/>(Codeberg)`"]
        META["`🔧 *tools/gen_meta.py*<br/>languages.json + version.json`"]
        CI["`⚙️ *CI regen-meta.yml*<br/>gen_toc_html.py`"]
        PG["`🌐 **Codeberg Pages**`"]
        WLB["`🌐 **Weblate** · linkenhancer/wthb-toc`"]
        TNG["🗝 en.json · fr.json · …"]
    end

    subgraph MODULE["📦 Modul (linkenhancer)"]
        SVC["`**WthbTocService**`"]
        DS["`💾 *data/…/wthb-toc-lang/*<br/>2-Layer-Cache`"]
        RDR["`📄 **help-wthb-toc.phtml**<br/>TOC-Modal`"]
    end

    OUT -->|"cp wthb-toc.json + de.json"| DEP
    DEP -->|"git add / commit / push"| REPO
    REPO -->|"regen meta"| META
    REPO --> CI --> PG
    REPO -->|"de.json (Source)"| WLB
    WLB --> TNG
    TNG -->|"[lang].json"| REPO
    PG -->|"fetch JSON"| MODULE
    SVC --> DS --> RDR

    classDef coreStyle fill:#ede7f6,stroke:#5e35b1,stroke-width:2px
    classDef okStyle fill:#e8f5e9,stroke:#2e7d32,stroke-width:2px
    classDef queueStyle fill:#fff3e0,stroke:#e65100,stroke-width:2px

    class OUT okStyle
    class DEP,REPO,META,CI,SVC coreStyle
    class PG,TNG,DS,RDR okStyle
    class WLB queueStyle
wt-deploy-toc-lang.sh kopiert wthb-toc.json und de.json in das Repo linkenhancer-wthb-toc-lang, führt tools/gen_meta.py aus (regeneriert languages.json + version.json) und macht git add/commit/push. Es ist standalone aufrufbar und skippt weich (Warnung + exit 0), wenn Repo oder JSON fehlen, sodass es den set -e-Orchestrator nie abbricht.
Repo-CI (regen-meta.yml) führt gen_toc_html.py aus und veröffentlicht auf Codeberg Pages.
Weblate
Die de.json im Repo ist die Quelle der Weblate-Komponente wt-modules/linkenhancer-wthb-toc; die übrigen [lang].json-Dateien sind deren Übersetzungs-Ziele. Die Übersetzungen fließen zurück ins Repo und werden über Codeberg Pages ausgeliefert.
rsync das Modul nach dist/linkenhancer/ und schließt alles aus, das nicht ausgeliefert wird (unten).
Erzeugt dist/linkenhancer_v<version>.zip.
Aus dem Archiv ausgeschlossen
create-archive.sh lässt unter anderem aus: node_modules/, .git*, gulpfile.mjs, package*.json, phpstan*, tests/, die util/*-Buildskripte, resources/js/src, resources/js/tests, resources/img/, resources/lang/*.po / *.mo und .env. Ausgeliefert werden nur die gebauten bundle*-JS/CSS, die kompilierten resources/lang/*.php, src/, resources/views/, resources/css/ und die Modul-Entry-Dateien.
Veröffentlichen
Das Release in git taggen.
dist/linkenhancer_v<version>.zip mit Release-Notizen zu einem Codeberg-/GitHub-Release hochladen.
Das Archiv wird nicht ins Repo committet — es wird on demand erzeugt und dem Release beigefügt.
3 - wt-shared-libs
Gemeinsame PHP-Bibliothek für benutzerdefinierte webtrees-Module
wt-shared-libs ist die gemeinsame PHP-Bibliothek hinter den benutzerdefinierten Modulen LinkEnhancer und Cronjob. Sie sorgt dafür, dass zwei webtrees-Hauptversionen (2.2 und 2.3) nebeneinander funktionieren: versionsabhängige Klassen, Methoden und Signaturen werden hier einmal gekapselt, statt in jedem Modul dupliziert.
Alles liegt unter der PSR-4-Root Schwendinger\Webtrees\. Die vollständige Methoden-API ist im Repository dokumentiert — diese Seite dient nur als Überblick:
Vollständige Methoden-API: reference.md
im Repository.
So funktioniert der Loader
autoload.php
ist ein skew-toleranter Loader: Er vergleicht die vom Modul mitgelieferte Lib-Version mit der im webtrees-Root installierten Version und lässt immer die neueste Kopie gewinnen — so kann eine veraltete, gebündelte Kopie eine neuere Site-Ebene niemals überschatten. Eine Regel für Konsumenten: die Lib nicht im __construct() der Modul-Klasse laden — das kann die Autoload-Reihenfolge verändern. Die vollständigen Prämissen und der Beweis stehen in reference.md
.
Schnellstart (als konsumierendes Modul)
Ein Path-Repository im composer.json des Moduls ergänzen und den Loader in der eigenen Lade-Routine registrieren (nach den anderen Composer-Libraries):